Capítulo 1: Evaluar las limitaciones y posibilidades de las IA generativas a partir de su funcionamiento.
Autora: Hiba Asri, Abdelali Rochdi; Adaptación: Ambroise Baillifard & Henrietta Carbonel
1. Comprender los fundamentos de la inteligencia artificial
Recomendaciones personalizadas, asistentes de voz, filtros antispam, vehículos autónomos... La IA ya forma parte de nuestra vida cotidiana.
- ¿Qué abarca realmente la «inteligencia artificial»?
- ¿Cómo consiguen estos sistemas «aprender»?
- ¿En qué se diferencia su funcionamiento del de la inteligencia humana?
- ¿Por qué responder a estas preguntas puede ayudar a utilizar mejor las herramientas de IA durante los estudios?
En este capítulo, intentaremos responder a estas preguntas abordando las diferentes formas de IA, su evolución, sus mecanismos de aprendizaje y el papel central de los datos.
La historia de la IA: de Turing a GPT
La realidad está lejos de alcanzar a la ficción cinematográfica
Antes de comenzar, aclaremos qué no es la IA actual. No es una IA general (IAG o IA fuerte) que pueda aprender y razonar de manera autónoma en todos los ámbitos, como un ser humano. Una IA de este tipo sería capaz de transferir conocimientos, adaptarse a situaciones nuevas y demostrar sentido común.
Imagen. Ejemplo de IA fuerte [película]: HAL 9000 en «2001: Una odisea del espacio» (1968, Stanley Kubrick)
La IA más popular es la IA generativa (GenAI). Está diseñada para producir contenido (texto, imágenes, sonido, vídeo) a partir de datos de entrenamiento. Es un tipo de IA débil (weak AI), es decir, sistemas diseñados para realizar tareas específicas, sin conciencia ni comprensión real, como ChatGPT, Midjourney, DeepMind, DALL·E o Copilot.
Los hitos históricos
La inteligencia artificial se ha desarrollado progresivamente, con períodos de cuestionamiento:
| Año | Acontecimiento clave | Impacto en la actualidad |
|---|---|---|
| 1950 | Alan Turing plantea la pregunta «¿Pueden pensar las máquinas?» y crea la prueba de Turing para evaluar la capacidad de una máquina de imitar una conversación humana. | La idea de evaluar una IA como GPT según su capacidad para imitar al ser humano sigue presente en las evaluaciones de rendimiento. |
| 1956 | Conferencia de Dartmouth: nacimiento oficial del campo de la «inteligencia artificial» y desarrollo de los primeros sistemas simbólicos (GOFAI). | El término «IA» configura nuestro imaginario, aunque podrían haberse utilizado otros términos («máquinas predictivas»; «sistemas estadísticos de tratamiento de datos»; «sistemas predictivos»). |
| 1974–1980 | Primer invierno de la IA: decepción ante las limitaciones de los sistemas simbólicos. | Recordatorio: los avances de la IA no están garantizados. |
| 1986 | Resurgimiento del conexionismo y la retropropagación, que permite entrenar las redes neuronales. | GPT funciona ajustando miles de millones de parámetros, no razonando. |
| 1987–1993 | Segundo invierno de la IA: hundimiento del mercado de los sistemas expertos y reorientación de la investigación. | Recordatorio: los avances de la IA no están garantizados. |
| 1990–2000 | Auge del aprendizaje automático estadístico (SVM, bosques aleatorios, árboles de decisión), impulsado por el enorme aumento del volumen de datos y de la capacidad de cálculo. | La calidad y la diversidad de los datos siguen siendo fundamentales. Si el tema es muy especializado, el LLM (GPT) ofrecerá más respuestas inexactas. |
| 2012 | Auge del aprendizaje profundo (Deep Learning): AlexNet revoluciona el reconocimiento de imágenes y abre el camino a las arquitecturas convolucionales. | La red aprende por sí misma qué características extraer, pero necesita enormes cantidades de datos y potencia de cálculo. |
| 2022–2025 | Expansión de la IA generativa (GPT-4o, Claude 4, Gemini, DALL-e, Midjourney). Aparición de desafíos sociales: sesgos, alucinaciones, cuestiones éticas y regulación. | Estas herramientas asombrosas, fruto de la tecnología, siguen teniendo sesgos, cometen errores con frecuencia y pueden utilizarse para causar daño. |
La IA en 2025
En el ámbito educativo, la IA parece converger hacia los grandes modelos de lenguaje, que se han vuelto especialmente populares.
Para mantenerse al día sobre los principales modelos, consulte periódicamente la siguiente documentación:
Para mantenerse al día sobre los modelos más destacados, consulte periódicamente la siguiente documentación:
-
GPT (OpenAI): https://platform.openai.com/docs/models
-
Claude (Anthropic): https://docs.anthropic.com/en/docs/about-claude/models/overview
-
Gemini (Google): https://ai.google.dev/gemini-api/docs/models?hl=es
-
Mistral (Mistral AI): https://docs.mistral.ai/models/
Comparación del rendimiento de los modelos
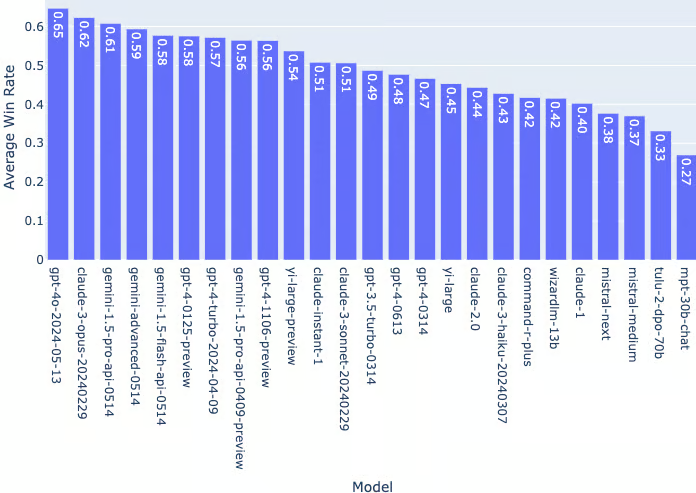
Comparativa realizada por Wielded (17 junio 2024). GPT-4o Benchmark - Detailed Comparison with Claude & Gemini
Innovaciones recientes:
- Multimodalidad (texto + imagen + audio + vídeo): ahora es posible trabajar directamente con materiales reales (capturas de pantalla, PDF escaneados, gráficos, diagramas y grabaciones). Por ejemplo, se puede pedir: «Describe este gráfico (ejes, tendencia, anomalías) y propón una interpretación en cuatro líneas».
- Generación aumentada por recuperación (RAG): el modelo busca fragmentos en una base de documentos (materiales de clase, artículos, apuntes) y fundamenta sus respuestas en ellos. Esto reduce las respuestas irrelevantes. Por ejemplo, se puede pedir: «Compara las posiciones de los autores [A] y [B] sobre [tema] a partir de este conjunto de documentos exportados».
- Cadenas explícitas de razonamiento («chain-of-thought»): el modelo descompone la tarea (hipótesis, etapas, cálculos principales) en lugar de limitarse a dar una conclusión; esto resulta útil para reducir las alucinaciones.
La regulación europea (2025):
- El Reglamento de Inteligencia Artificial (AI Act), que entró en vigor en junio de 2025, impone a los proveedores de modelos de IA generativa obligaciones de transparencia, gestión de riesgos y supervisión de sesgos para proteger a los usuarios.
¿Qué es la inteligencia artificial?
Definición
El concepto de inteligencia abarca realidades muy distintas según las disciplinas (psicología, filosofía, informática). Podemos decir que la inteligencia artificial (IA) engloba sistemas que buscan reproducir determinadas funciones cognitivas humanas, como el razonamiento, el aprendizaje, la percepción, el procesamiento del lenguaje o la toma de decisiones.
Estas son dos definiciones históricas:
« La ciencia y la ingeniería de fabricar máquinas inteligentes » John McCarthy (1955).
« La ciencia de hacer que las máquinas hagan cosas que requerirían inteligencia si las hicieran los seres humanos » Marvin Minsky (1968).
Un ejemplo disparatado
Según estas definiciones, una tostadora «inteligente» que ajusta el tostado según el color del pan… es IA. Entonces, ¿por qué los LLM (GPT) parecen mucho más impresionantes?
Para recordar
La inteligencia de una máquina consiste en su rendimiento. La IA «simula» ser inteligente, sin conciencia ni comprensión.
¿Por qué se califica a la IA de "inteligente"?
La inteligencia artificial generativa no posee inteligencia en el sentido humano (ni conciencia, ni intuición, ni comprensión del mundo que la rodea). Su rendimiento se basa en cálculos, modelos estadísticos y datos. Se la califica de «inteligente» porque es capaz de reproducir determinados comportamientos que normalmente asociamos con la inteligencia humana:
- Reconoce patrones o regularidades en grandes cantidades de datos (por ejemplo, rostros, palabras u objetos).
- Puede aprender de la experiencia, especialmente a partir de ejemplos etiquetados que sirven como base de entrenamiento.
- Genera respuestas o contenido basándose en modelos estadísticos. No se trata de decisiones, sino de una sucesión de predicciones probabilísticas adaptadas a una situación concreta.
"Saber" qué es un gato
Un niño aprende a reconocer un gato observando varios ejemplos, a menudo muy pocos. De manera similar, una IA generativa aprende a identificar las características visuales o textuales de un gato analizando miles de ejemplos. No comprende qué es un gato, pero sabe producir una representación fiel.
Implicación práctica
Ante una «inteligencia» estadística y no cognitiva, quien utiliza un LLM debe orientar la máquina con precisión. No aplicar inteligencia al solicitar algo a un LLM (es decir, proporcionar entradas de baja calidad, también llamado «garbage in») aumenta considerablemente la probabilidad de obtener respuestas de baja calidad («garbage out»).
La IA débil y la IA fuerte
¿Por qué es útil conocer esta distinción?
Comprender que ChatGPT es una IA débil:
- te evita pedirle tareas fuera de su ámbito de competencia
- te ayuda a aprovechar sus puntos fuertes: reformulación, programación y síntesis
- te ayuda a elegir una fuente más fiable cuando corresponde
Lejos de las fantasías de la ciencia ficción (Her, Ex Machina, Westworld…), la IA no es consciente:
La IA no tiene capacidad para sentir, experimentar emociones, mostrar curiosidad, salir del ámbito para el que fue diseñada ni tener conciencia de sí misma. (Audureau, 2024)
Hasta ahora, la IA realiza tareas concretas, sin razonamiento ni comprensión real de lo que hace. Se denomina «IA débil» porque no puede adaptarse a contextos distintos de aquellos para los que ha sido entrenada. Pensemos en asistentes de voz (como Siri o Alexa), chatbots que responden a preguntas sencillas o algoritmos de recomendación que sugieren productos en línea: no saben jugar al ajedrez ni cultivar un jardín.
La IA que aparece en algunas películas de ciencia ficción se denomina «fuerte» porque se imagina capaz de «razonar», comprender y aprender de forma autónoma en cualquier ámbito, como un ser humano. En Hollywood, la IA suele tener flexibilidad cognitiva: resuelve problemas nuevos, aprende de la experiencia, transfiere conocimientos de un ámbito a otro, etc.
El ejemplo de un chatbot
Este es un ejemplo de un chatbot utilizado como asistente personalizado para la venta de productos cosméticos:
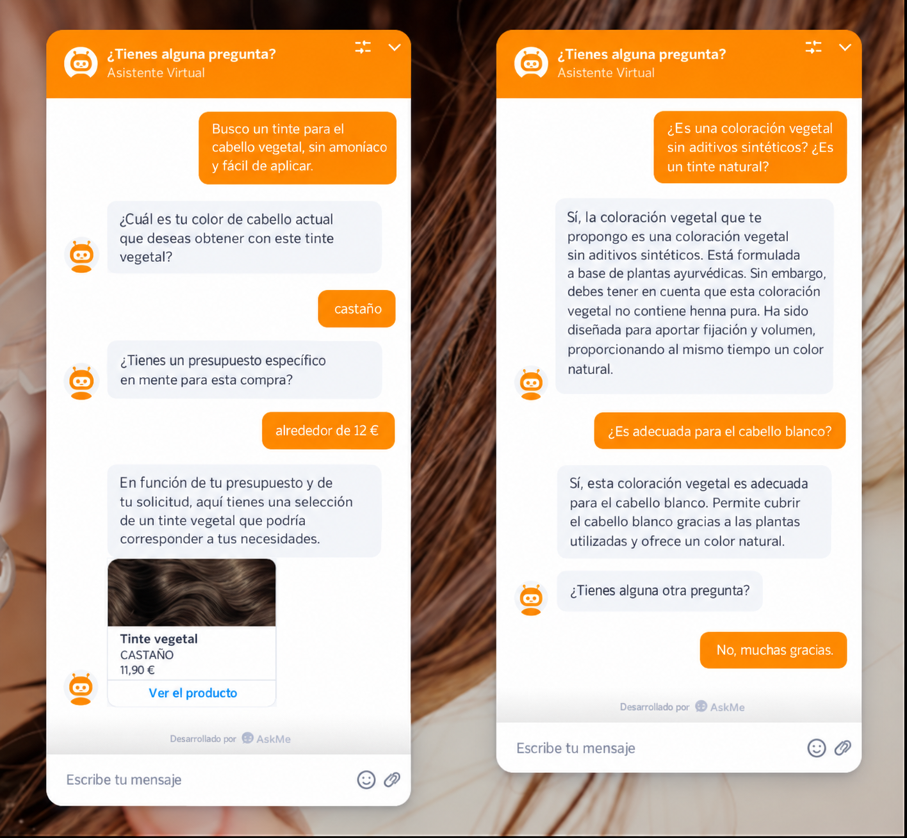
Fuente de la imagen: iAdvize
Aunque desempeña el papel de experto haciendo preguntas concretas a la consumidora para recomendarle el producto más adecuado, sería incapaz de diagnosticar una avería mecánica o escribir una novela: por tanto, es una IA débil.
¿Qué es una IA generativa?
Una inteligencia artificial generativa (IA generativa) es un sistema informático capaz de producir automáticamente contenido (texto, imágenes, sonido, código, vídeos, etc.) a partir de datos de entrenamiento. Se basa en modelos avanzados, como las redes neuronales profundas, que aprenden a generar resultados imitando los ejemplos con los que han sido entrenados.
A diferencia de las IA tradicionales, diseñadas para clasificar o predecir, la IA generativa predice la siguiente palabra, imagen o sonido, lo que le permite generar textos, ilustraciones, voces, música y vídeos.
Ejemplos de IA generativa :
¿Cómo aprende la IA?
Tres factores han hecho posibles los modelos actuales (es decir, el desarrollo de algoritmos de clasificación a gran escala que permiten el aprendizaje automático y el aprendizaje profundo a gran escala):
- Big data: conjuntos masivos de datos disponibles en línea.
- Potencia de cálculo: especialmente gracias a las tarjetas gráficas (GPU), que permiten analizar y clasificar grandes bases de datos.
- Redes neuronales convolucionales (CNN) artificiales: capaces de detectar patrones complejos.
El proceso de desarrollo de un modelo de IA consta de cinco etapas:
- Recopilación de datos: reunir una gran cantidad de ejemplos representativos (textos, imágenes, sonidos, etc.) adecuados para la tarea prevista.
- Preparación de datos: limpiar los datos brutos, corregir errores, darles formato y, si es necesario, etiquetarlos (por ejemplo, identificar los objetos correctos en las imágenes).
- El entrenamiento del modelo: El algoritmo aprende a partir de los datos ajustando sus parámetros para minimizar los errores.
- La evaluación del rendimiento: Se prueba el modelo con nuevos datos para comprobar su capacidad de generalización (y evitar el sobreajuste).
- El despliegue: Una vez validado, el modelo puede integrarse en una aplicación concreta y utilizarse en condiciones reales (motor de recomendación, diagnóstico médico, asistente de voz…).
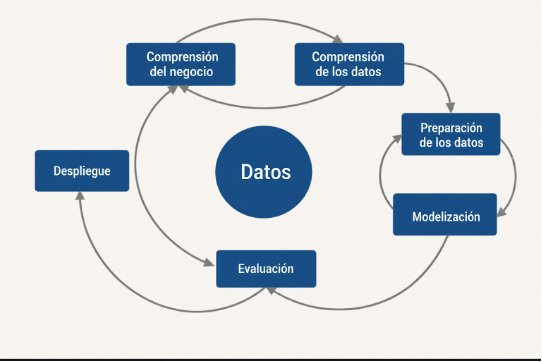
Ilustración: ciclo de vida de un modelo de IA generativa, que muestra las diferentes etapas de un proceso cíclico. Los modelos se vuelven a entrenar y ajustar periódicamente a lo largo del tiempo.
El Machine Learning
Los algoritmos de Machine Learning son programas capaces de identificar patrones recurrentes en los datos (textos, imágenes, audio) sin que cada etapa tenga que programarse manualmente. En lugar de indicar a la máquina cómo resolver un problema, se le proporcionan ejemplos a partir de los cuales aprende por sí misma.
Definición
El Machine Learning (ML) es una subdisciplina de la IA que consiste en desarrollar algoritmos capaces de aprender automáticamente a partir de datos, sin estar programados explícitamente para cada tarea. El modelo «aprende» ajustando sus parámetros para mejorar sus predicciones o decisiones a partir de ejemplos.
Ejemplo: predecir el precio de una vivienda en función de su superficie y ubicación tras haber sido entrenado con un historial de ventas.
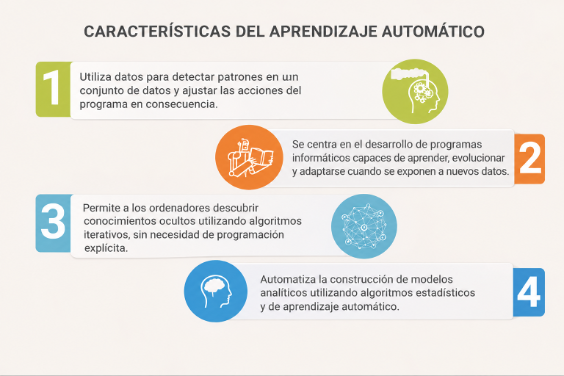
Los algoritmos de Machine Learning pueden clasificarse según cuatro grandes enfoques de aprendizaje, en función de la naturaleza de los datos y de los objetivos que se persiguen (Priyadharshini, 2025):
| Tipo de aprendizaje | Descripción | Ejemplo concreto |
|---|---|---|
| Supervisado | El modelo aprende a partir de datos etiquetados, en los que se conoce la «respuesta correcta». Busca predecir un resultado a partir de ejemplos. | Predecir el precio de una vivienda en función de su superficie, ubicación, etc. |
| No supervisado | El modelo analiza datos no etiquetados para descubrir estructuras ocultas o agrupaciones naturales. | Segmentar a los clientes según sus hábitos de compra. |
| Semi-supervisado | El modelo analiza tanto datos no etiquetados como datos etiquetados. | Predecir el riesgo de abandono escolar con pocos expedientes etiquetados y muchos datos no etiquetados. |
| Por refuerzo | El modelo aprende mediante ensayo y error, recibiendo recompensas o penalizaciones según sus acciones. | Un robot aprende a caminar o un agente virtual aprende a jugar al Go. |
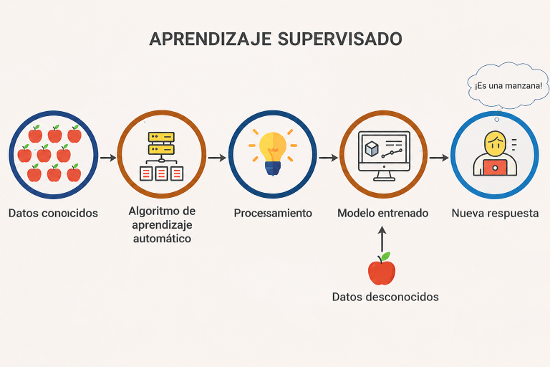
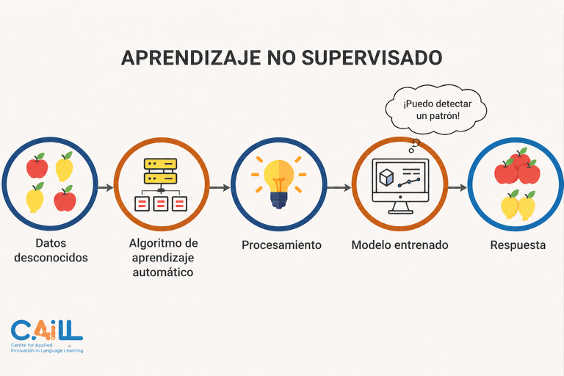
Referencias: SimpliLearn (2025)
Un vídeo ameno para comprender el aprendizaje por refuerzo
Este entretenido vídeo explica de forma sencilla en qué consiste el aprendizaje por refuerzo:
El Deep Learning y las redes neuronales
El Deep Learning, o aprendizaje profundo, es una subcategoría del Machine Learning (Priyadharshini, 2025). Se basa en redes neuronales artificiales cuya arquitectura se inspira en el funcionamiento del cerebro humano (LeCun, Bengio y Hinton, 2015). Estas redes pueden aprender a partir de cantidades muy grandes de datos y son especialmente eficaces en tareas complejas como el reconocimiento de imágenes, la traducción automática o la comprensión del lenguaje.
Definición
El Deep Learning (DL) es una subdisciplina del Machine Learning basada en redes neuronales artificiales profundas (con varias capas ocultas). Estos modelos pueden procesar cantidades muy grandes de datos y extraer automáticamente representaciones complejas, lo que los hace especialmente eficaces con datos no estructurados, como imágenes, sonidos o lenguaje natural (LeCun, Bengio y Hinton, 2015).
Ejemplo: reconocer rostros automáticamente o generar un texto coherente a partir de un prompt (como hace ChatGPT).
Cómo funciona el Deep Learning ?
Una red neuronal procesa la información en varias etapas, a través de distintas capas. Cada una de ellas aprende a extraer características cada vez más complejas.
- Entrada: se proporciona al sistema un dato sin procesar (por ejemplo, una imagen).
- Capas ocultas: la información atraviesa varias capas intermedias, donde se transforma y analiza en distintos niveles de abstracción.
Por ejemplo, en el caso de una imagen:
- las primeras capas identifican formas sencillas, como líneas o colores,
- las capas siguientes detectan patrones más complejos, como texturas o formas,
- las últimas capas identifican elementos reconocibles, como una oreja, un ojo o un rostro.
Salida: la red produce una predicción (por ejemplo, «gato» » o «perro»).
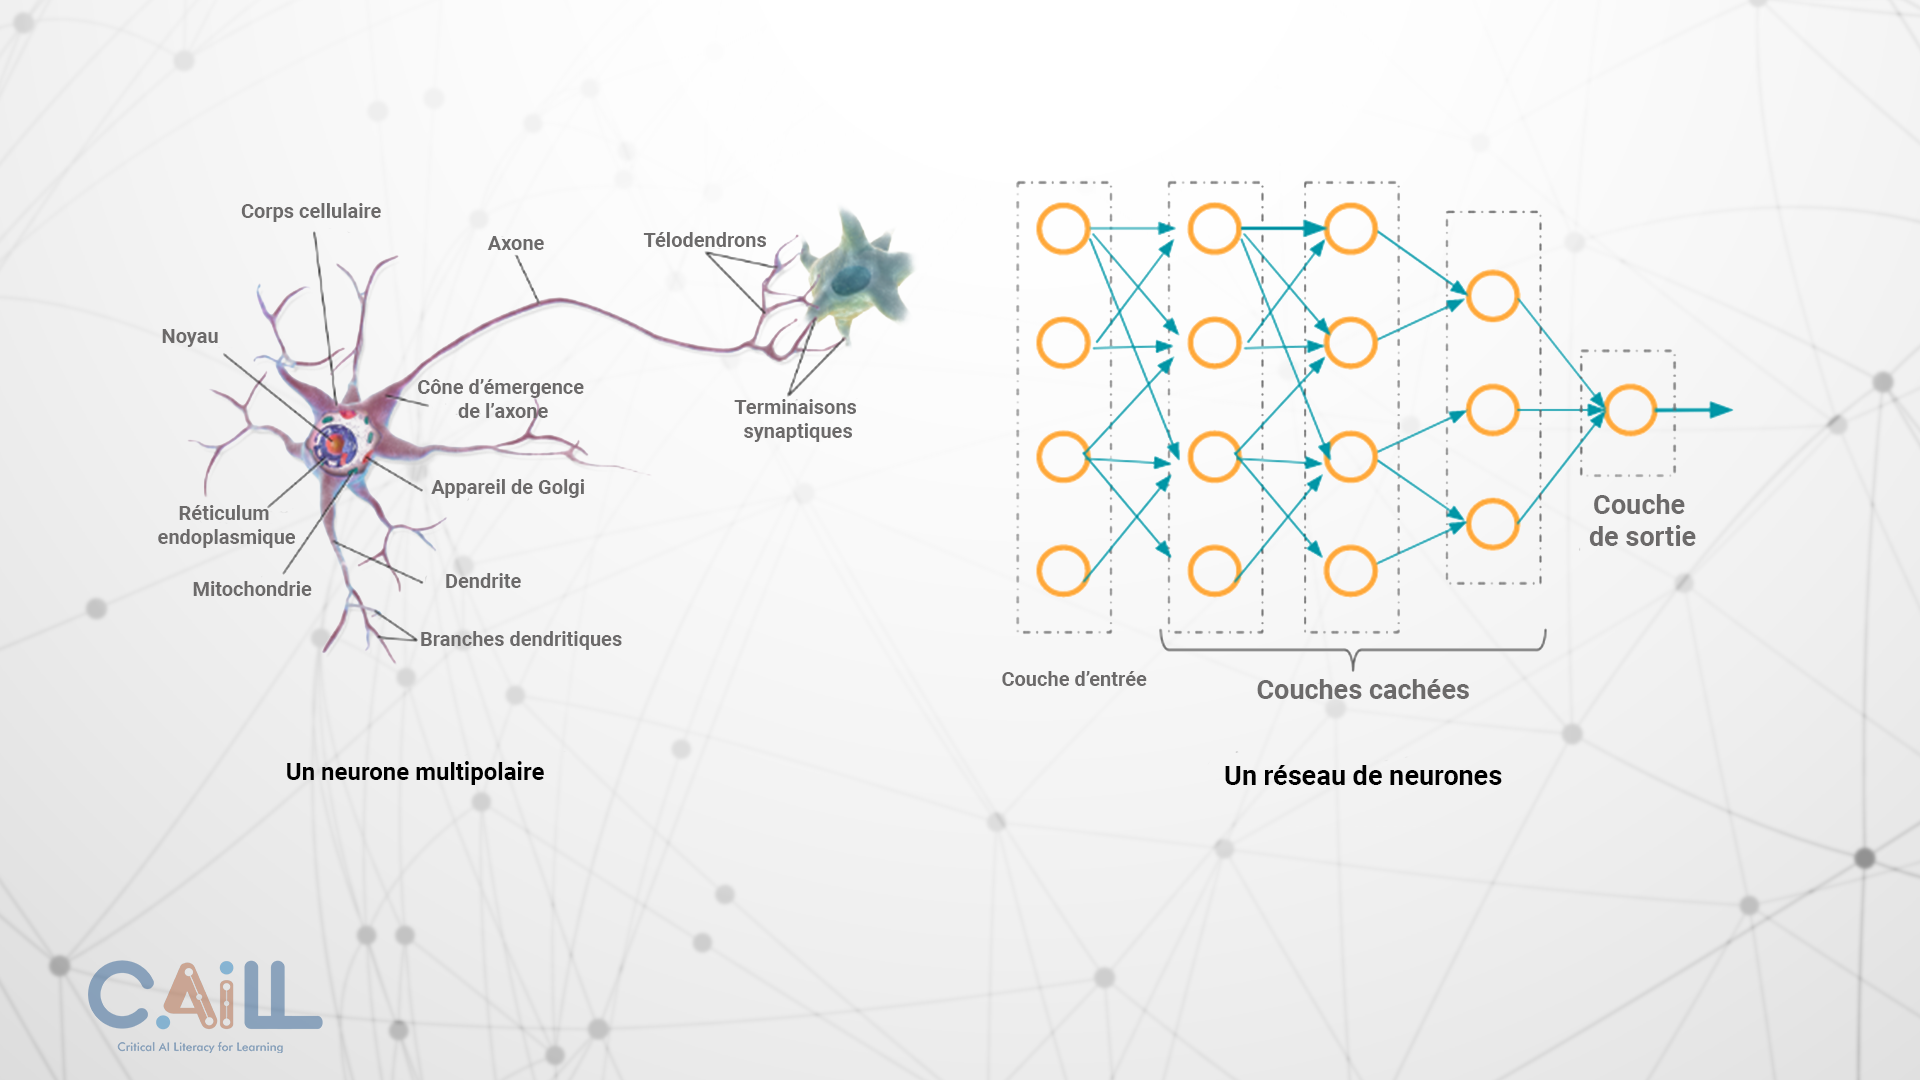
A la izquierda: una neurona humana multipolar; a la derecha: una red neuronal artificial.
Fuente: Gaël (2018), 3 Algorithmes de DeepLearning expliqués en Langage Humain
Una comparación entre Machine Learning y Deep Learning
El Deep Learning es una forma avanzada de Machine Learning que utiliza redes neuronales profundas para resolver tareas complejas.
| Aspecto | Machine Learning | Deep Learning |
|---|---|---|
| Cantidad de datos | Funciona con pocos datos | Necesita grandes cantidades de datos |
| Complejidad de los modelos | Modelos sencillos, a menudo interpretables | Redes profundas con numerosas capas, difíciles de interpretar |
| Capacidad de análisis | Menos adecuado para datos no estructurados | Muy eficaz con imágenes, sonidos, textos… |
| Recursos necesarios | Menor consumo de recursos de cálculo | Muy exigente (necesita GPU, computación en la nube…) |
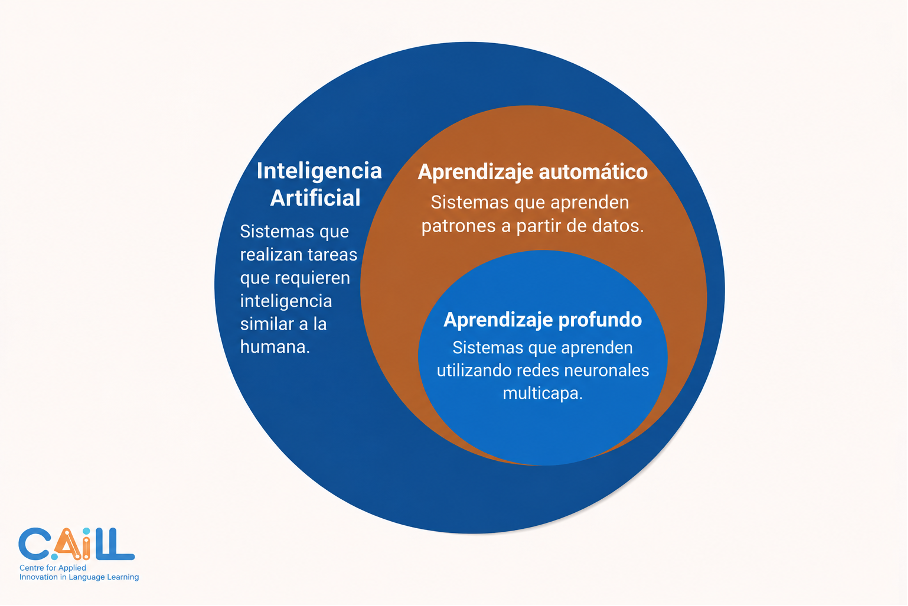
El deep learning como subcampo del machine learning, que a su vez es un subcampo de la inteligencia artificial.
Fuente: IONOS
Referencias
-
Audureau, W. (20 avril 2024). Tout comprendre à l’intelligence artificielle, cette technologie source de nombreux malentendus. Le monde. https://www.lemonde.fr/les-decodeurs/article/2024/04/20/tout-comprendre-a-l-intelligence-artificielle-cette-technologie-source-de-nombreux-malentendus_6228954_4355770.html
-
LeCun, Y., Bengio, Y., & Hinton, G. (2015). Deep learning. Nature, 521(7553), 436–444. https://doi.org/10.1038/nature14539
-
Priyadharshini (2025). What Is Machine Learning and How Does It Work?https://www.simplilearn.com/tutorials/machine-learning-tutorial/what-is-machine-learning
-
Russell, S. J., & Norvig, P. (2021). Artificial intelligence: A modern approach (4e éd.). Pearson.
2. Las inteligencias artificiales generativas
Las grandes familias de la IA generativa
La IA generativa (GenAI) no se limita al procesamiento de textos. Actualmente abarca una amplia variedad de contenidos, organizados en familias funcionales según los tipos de datos utilizados (texto, imagen, sonido, etc.) y sus aplicaciones. Cada familia utiliza modelos entrenados con conjuntos de datos específicos.
| Famille | Ejemplos | Applications |
|---|---|---|
| Texte (LLMs) | ChatGPT, Claude, Gemini | Redacción, resumen, traducción, conversación |
| Images | DALL·E, Midjourney | Generación de ilustraciones, diseño gráfico |
| Sons / Voix | VALL-E, ElevenLabs | Síntesis de voz, imitación de voces, narración |
| Vídeos | Sora, Runway | Creación de clips, animaciones y vídeos realistas |
| Code | GitHub Copilot, CodeWhisperer | Asistencia a la programación, generación de código |
Todos estos modelos se basan en el mismo principio de generación: la predicción de una secuencia lógica (palabra, píxel, nota, línea de código, etc.). Se diferencian según el tipo de datos con los que se entrenan.
Para recordar
Existen varias familias de IA generativa, pero todas predicen una secuencia lógica (palabra, píxel, sonido, código, etc.). Se diferencian por el tipo de datos de entrenamiento.
La IA generativa de texto (LLM)
Los grandes modelos de lenguaje (o LLM, por sus siglas en inglés, Large Language Models) son la base de numerosas herramientas de IA generativa de texto, como ChatGPT, Claude o Gemini. Estos modelos utilizan una arquitectura denominada Transformer, que les permite analizar un texto en su conjunto, teniendo en cuenta el contexto global en lugar de leer palabra por palabra.
Los conceptos clave para comprender los LLM
Numerosos términos están relacionados con la IA generativa. Estos son los conceptos importantes para comprender los LLM:
Los tokens
Los modelos de lenguaje no procesan directamente palabras completas, sino que las dividen en unidades más pequeñas llamadas tokens. Un token puede ser una palabra completa, una parte de una palabra o un signo de puntuación.
Diferentes métodos de segmentación (tokenización)
Una misma palabra puede representarse de distintas maneras según el método de tokenización. Por ejemplo, la palabra «astronaute» se dividirá así:
- astro + naute con GPT-4 (Byte Pair Encoding):
- astr + ##onaute con BERT (WordPiece)
Si la segmentación varía según el método, es porque cada modelo busca su propio equilibrio entre:
- Reducir el vocabulario (menos tokens diferentes que gestionar).
- Limitar la longitud de las secuencias (evitar dividir una palabra frecuente en demasiados fragmentos).
- Poder procesar palabras raras o nuevas (por ejemplo, nombres propios o errores tipográficos).
Esta infografía muestra la cantidad de tokens presentes en distintos tipos de documentos escritos, en función del número aproximado de palabras. Según la estimación de que 1 token = 0,75 palabras, un artículo breve representa 1000 tokens y un manual, un millón de tokens.
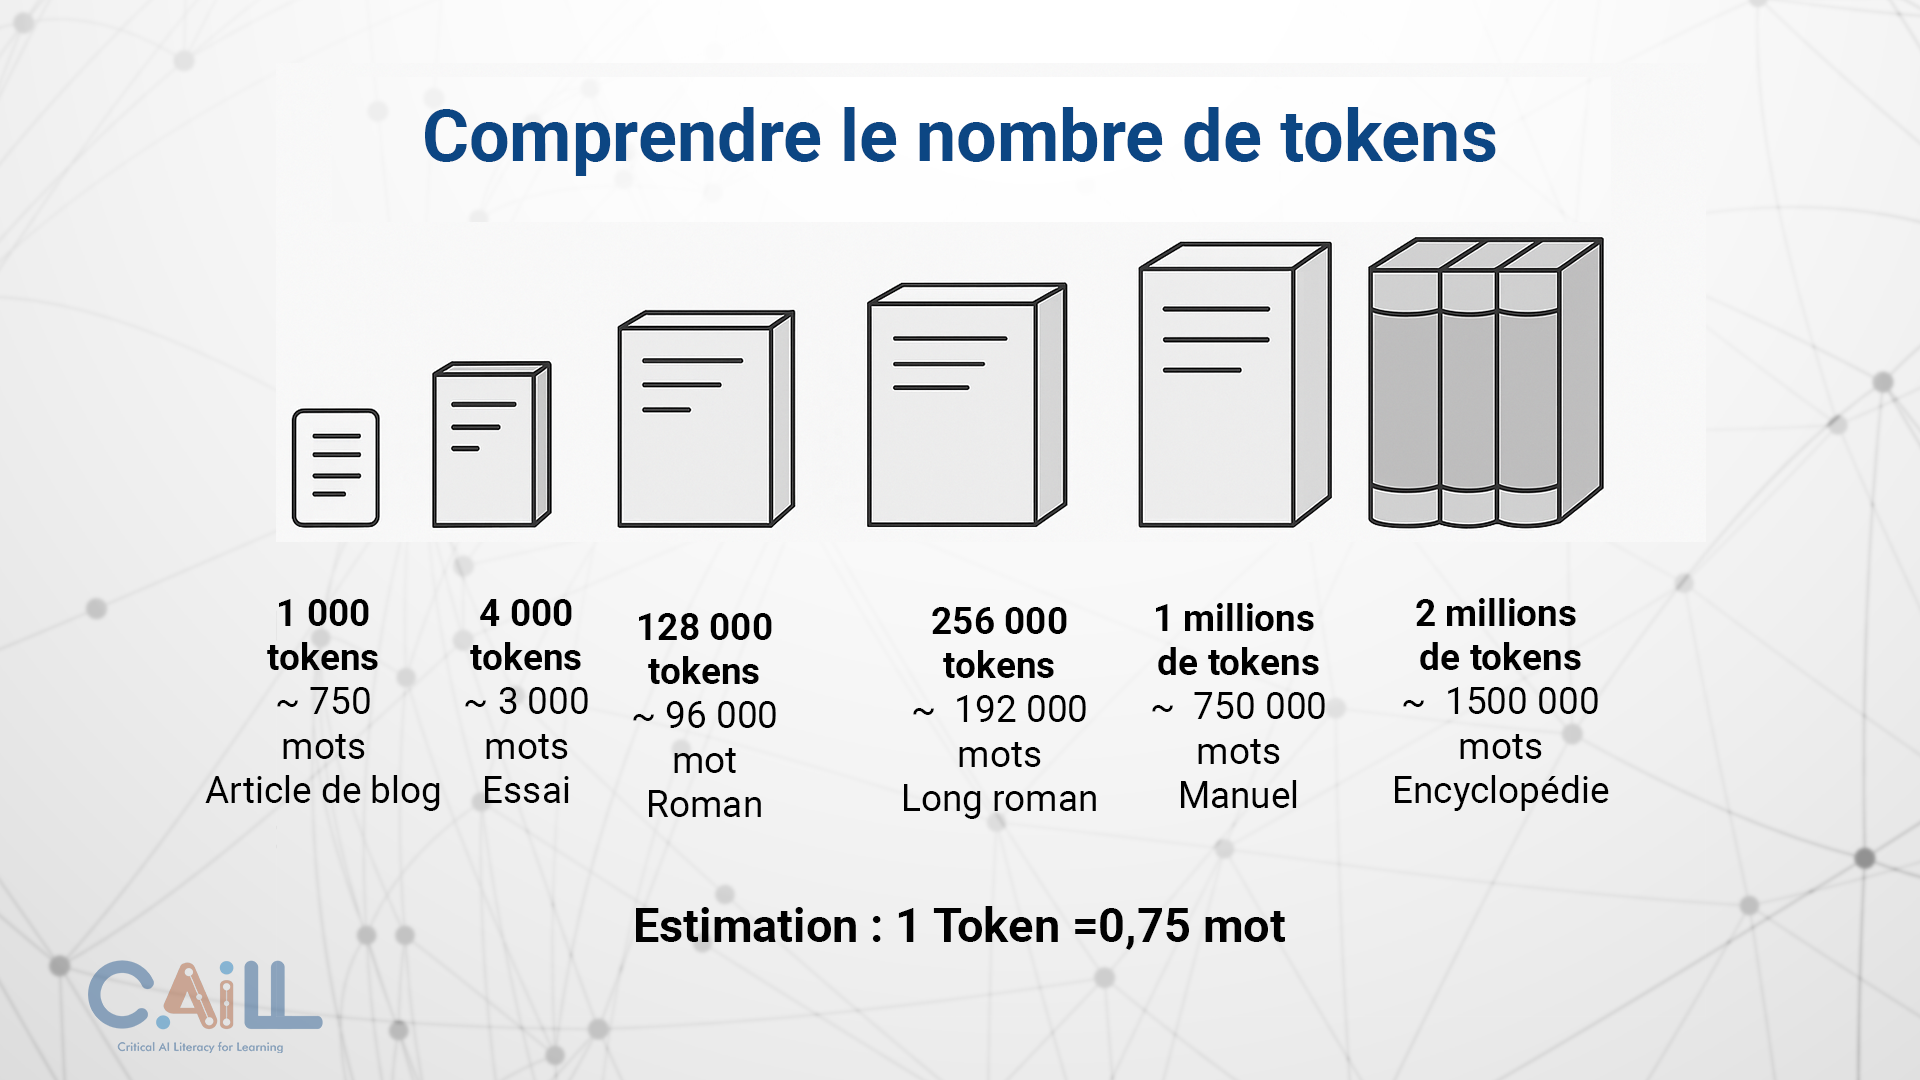
Fuente: CriticalMynd (2025).
El contexto
El contexto correspond à la cantidad de texto que el modelo puede tener en cuenta de una sola vez para producir una respuesta pertinente. Cuanto más largo sea el contexto, más podrá el modelo «recordar» lo que se ha dicho anteriormente en la conversación.
Ejemplo
El modelo GPT-3.5 tiene distintos límites de tokens según la versión utilizada:
- GPT-3.5-turbo-0613 : límite de 4 096 tokens (la extensión de un ensayo)
- GPT-3.5-turbo-1106 : límite de 16 385 tokens
A modo de comparación Gemini 1.5 Pro dispone de una ventana de contexto estándar de 128 000 tokens, con acceso experimental a hasta un millón de tokens para algunos desarrolladores a través de AI Studio o Vertex AI.
Estos límites incluyen tanto la entrada (prompt) et la sortie (respuesta) del modelo. Por ejemplo, si tu prompt utiliza 1 000 tokens, la respuesta generada no podrá superar los 15 385 tokens con la versión gpt-3.5-turbo-1106.
Comprender permite utilizar mejor
Saber que un LLM tiene una ventana de contexto permite comprender por qué un modelo «olvida» lo dicho anteriormente en una conversación o por qué resulta útil dividir una solicitud compleja en varias solicitudes más pequeñas. El usuario elegirá distintos modelos según las necesidades de su solicitud en cuanto a la ventana de contexto (una solicitud sencilla frente al resumen de un informe extenso).
Saber que un LLM pondera la importancia de cada parte de las instrucciones que recibe significa para el usuario que:
- el orden de los elementos en el prompt tiene poca importancia.
- mejorar la calidad del prompt mejora la calidad de la respuesta.
Le prompt
El prompt (o solicitud) corresponde a la instrucción o la pregunta formulada por el usuario, que desencadena la generación de texto. La calidad y la claridad del prompt influyen considerablemente en la respuesta. Por eso, se dedica un capítulo completo (LIEN INTERNE) al arte de diseñar prompts eficaces y a la interacción óptima con una IA generativa.
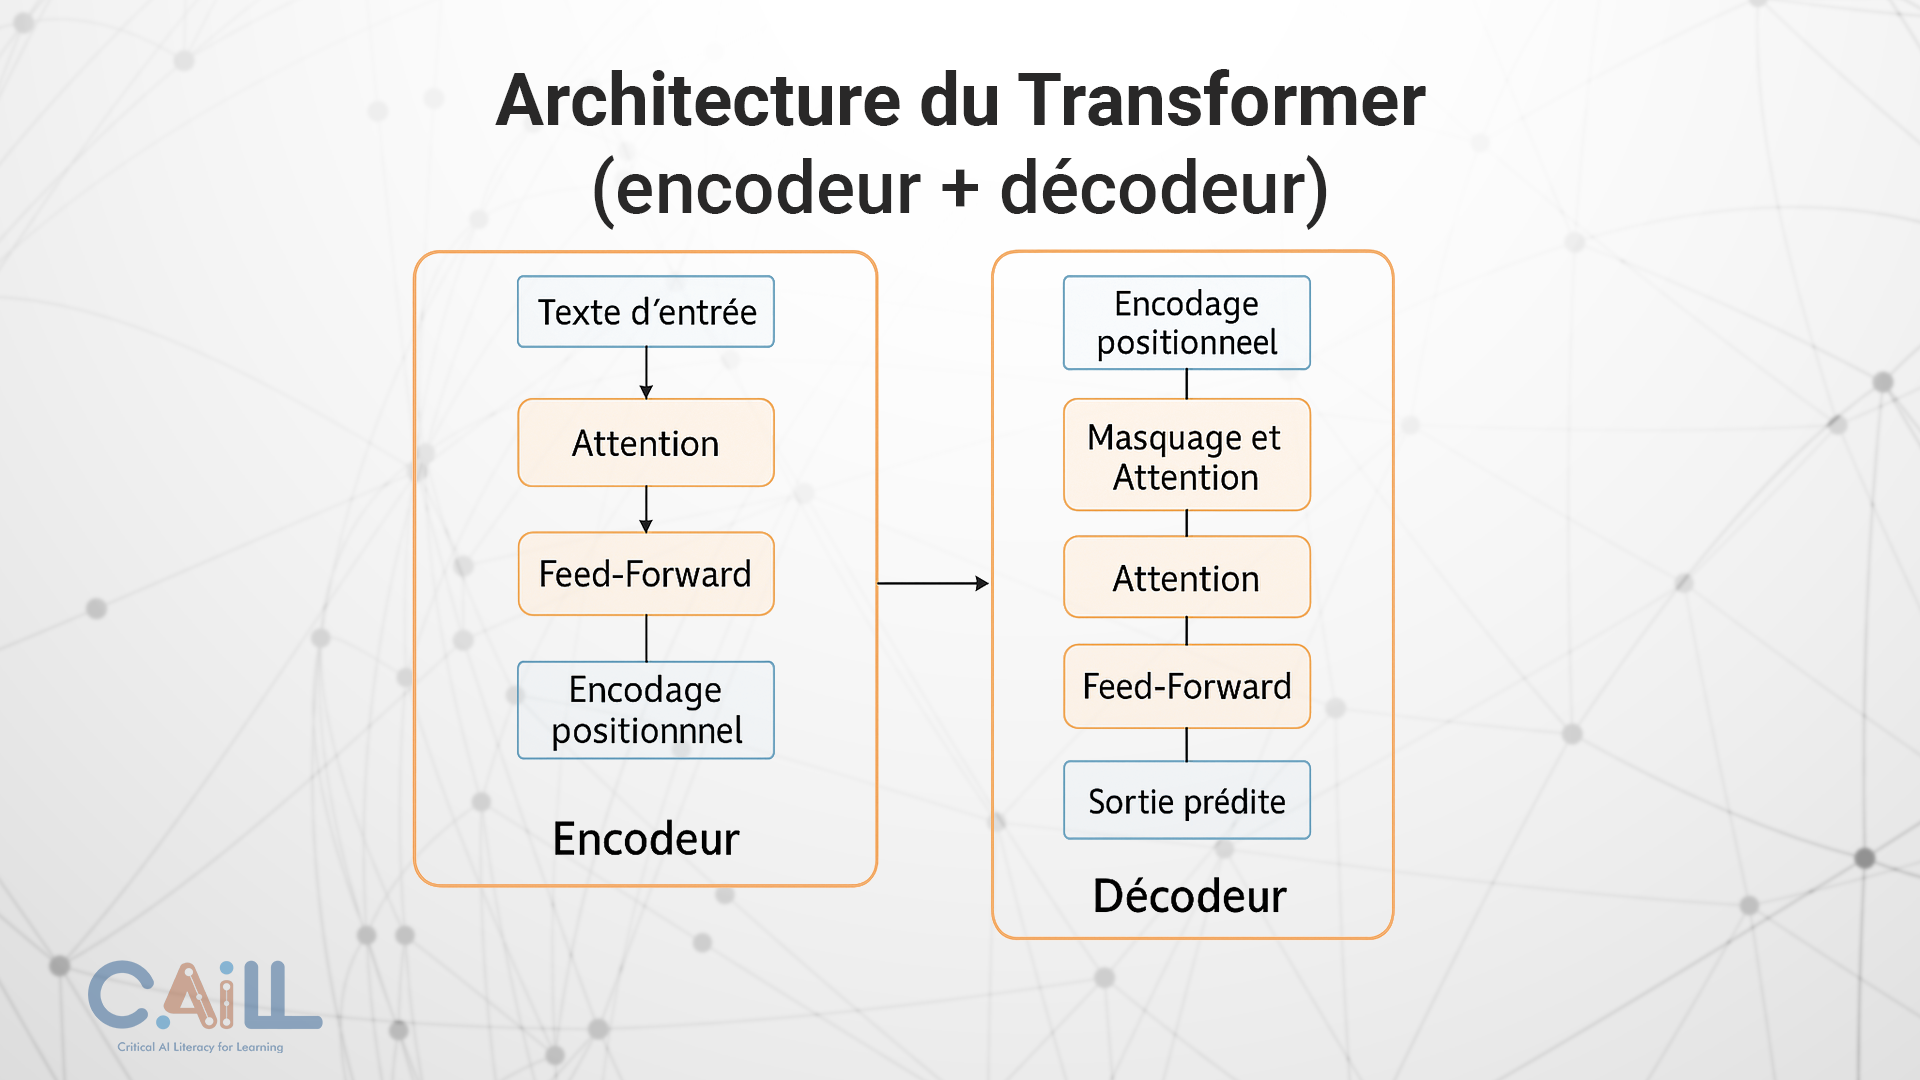
El transformador y la atención
Le transformer corresponde a la arquitectura de red neuronal introducida por Vaswani et al. (2017). El transformer procesa secuencias mediante mecanismos de atención para evaluar la importancia de cada elemento independientemente de su posición en la secuencia, sin recurrir a la recurrencia ni a la convolución.
En cuanto al mecanismo de atención, permite que un modelo se concentre en las partes más pertinentes de una secuencia al procesar un elemento, asignando un peso de importancia a cada parte.
Para recordar
- Token : unidad básica utilizada por los modelos de lenguaje (palabra, fragmento de palabra, carácter).
- Contexte : cantidad máxima de texto que el modelo puede analizar y recordar simultáneamente.
- Prompt (ou invite) : instrucción o indicación proporcionada al modelo para orientar su generación.
- Transformer : arquitectura fundamental de los modelos modernos, basada en el mecanismo deattention.
- Attention : mecanismo que permite al modelo ponderar la importancia de cada token en función de todas las demás palabras del contexto.
L'autosupervision (Self-Supervised Learning)
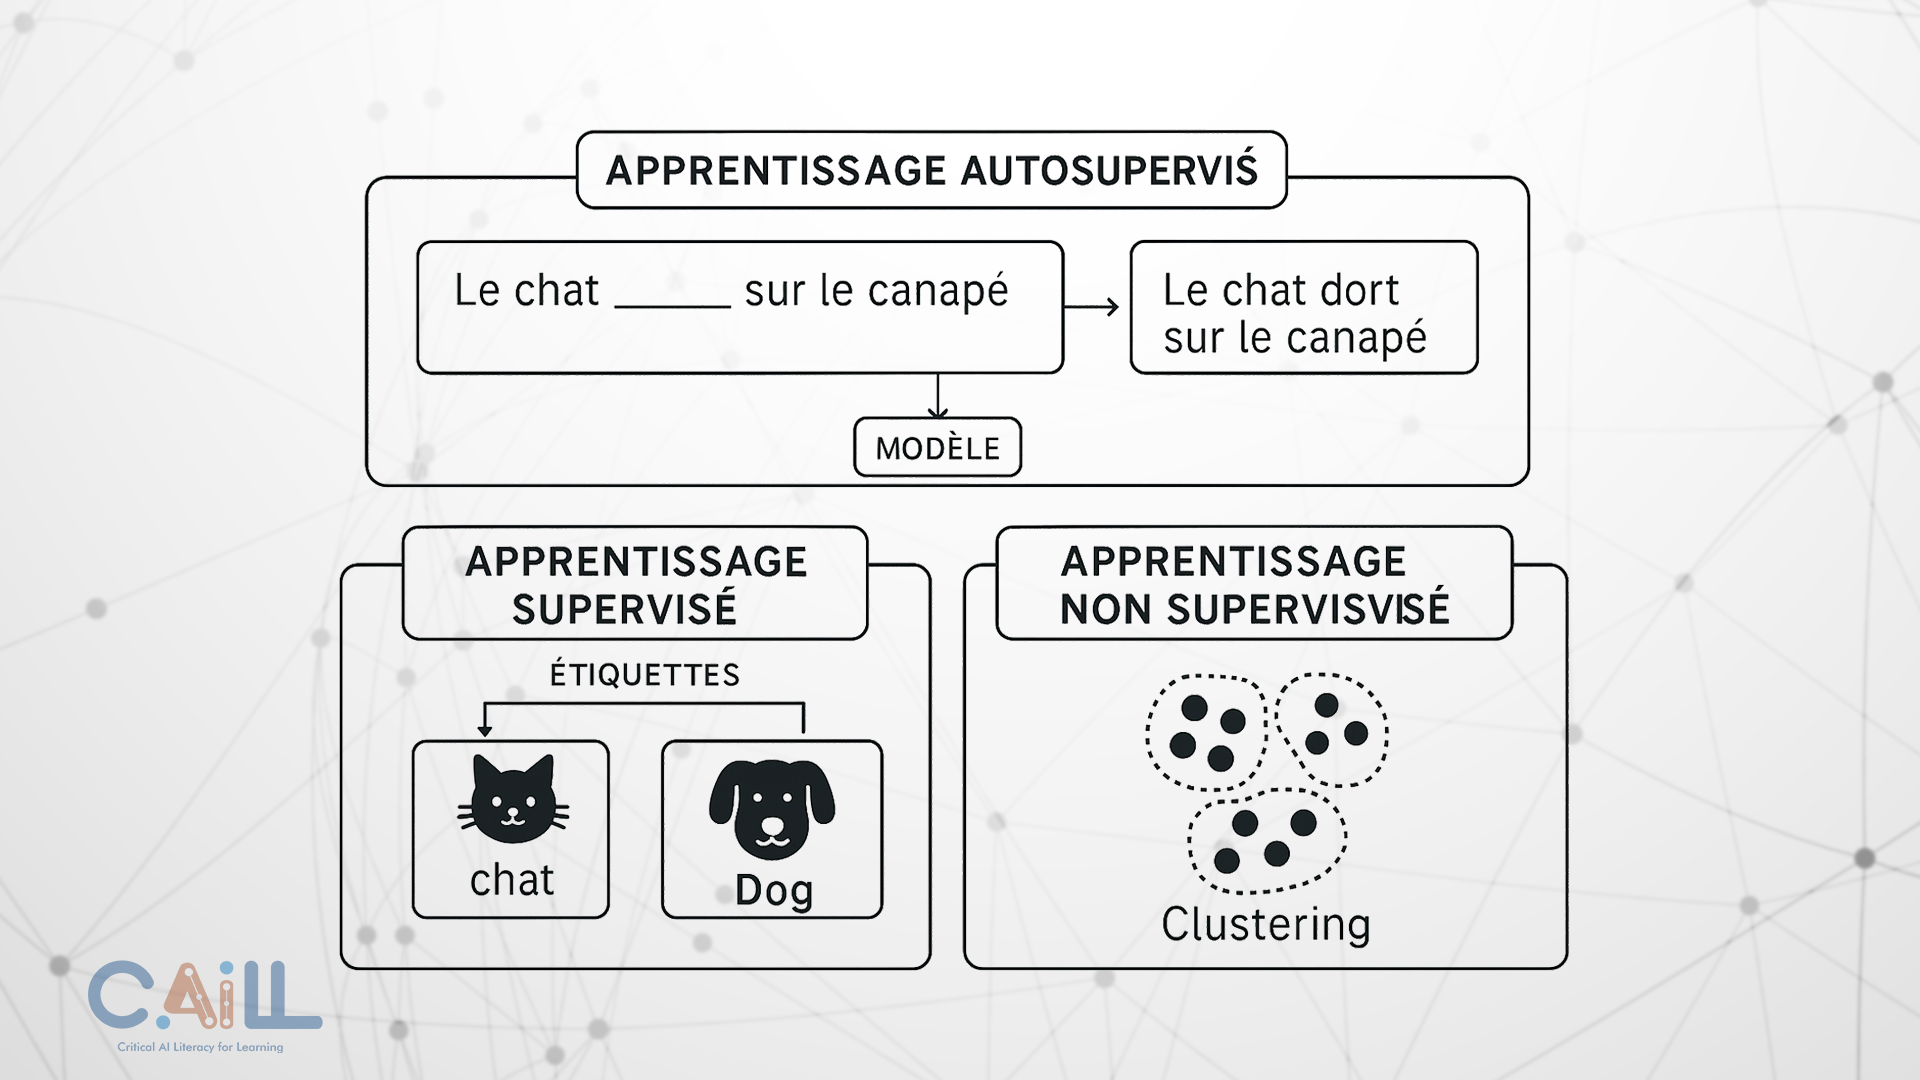
La etapa inicial de preentrenamiento de los LLM se basa en el aprendizaje autosupervisado. Esto significa que el modelo aprende a predecir elementos ocultos (palabra, frase) en un texto sin etiquetar. Este enfoque aprovecha enormes corpus de datos brutos, sin anotación humana, y permite adquirir representaciones ricas del lenguaje antes de cualquier ajuste fino.
La generalización
La generalización de un LLM se mide por su capacidad para aplicar sus conocimientos a tareas o ámbitos no vistos durante el entrenamiento. Se evalúa mediante protocolos en los que el modelo debe responder correctamente a instrucciones nuevas (denominados "zero-shot" et "few-shot "). La calidad de la generalización depende de la diversidad del corpus, de la profundidad de la red y de la eficacia de los algoritmos de optimización.
La IA generativa de imágenes
Las IA generativas de imágenes pueden transformar instrucciones textuales (o prompts) en representaciones visuales. Estos sistemas aprenden a crear imágenes originales a partir de millones de ejemplos, imitando los estilos, las formas y los colores observados en los datos de entrenamiento.
¿Cómo funciona?
- Se comienza eligiendo un modelo adecuado, como DALL·E, Midjourney o Stable Diffusion.
- Se dan las instrucciones mediante un prompt textual que describe la imagen deseada, por ejemplo: "un zorro con armadura medieval, estilo pintura al óleo".
- Esta familia de IA generativa utiliza un proceso llamado difusión, que consiste en añadir ruido aleatorio a una imagen y luego eliminarlo progresivamente para reconstruir una imagen que corresponda al prompt.
- Después se puede ajustar el resultado obtenido con nuevas instrucciones hasta conseguir lo que se desea.
Este enfoque permite generar imágenes muy detalladas, originales y a menudo sorprendentes desde el punto de vista artístico, pese a ciertas limitaciones, como errores anatómicos (por ejemplo, una mano con seis dedos).
El ejemplo de DALL·E
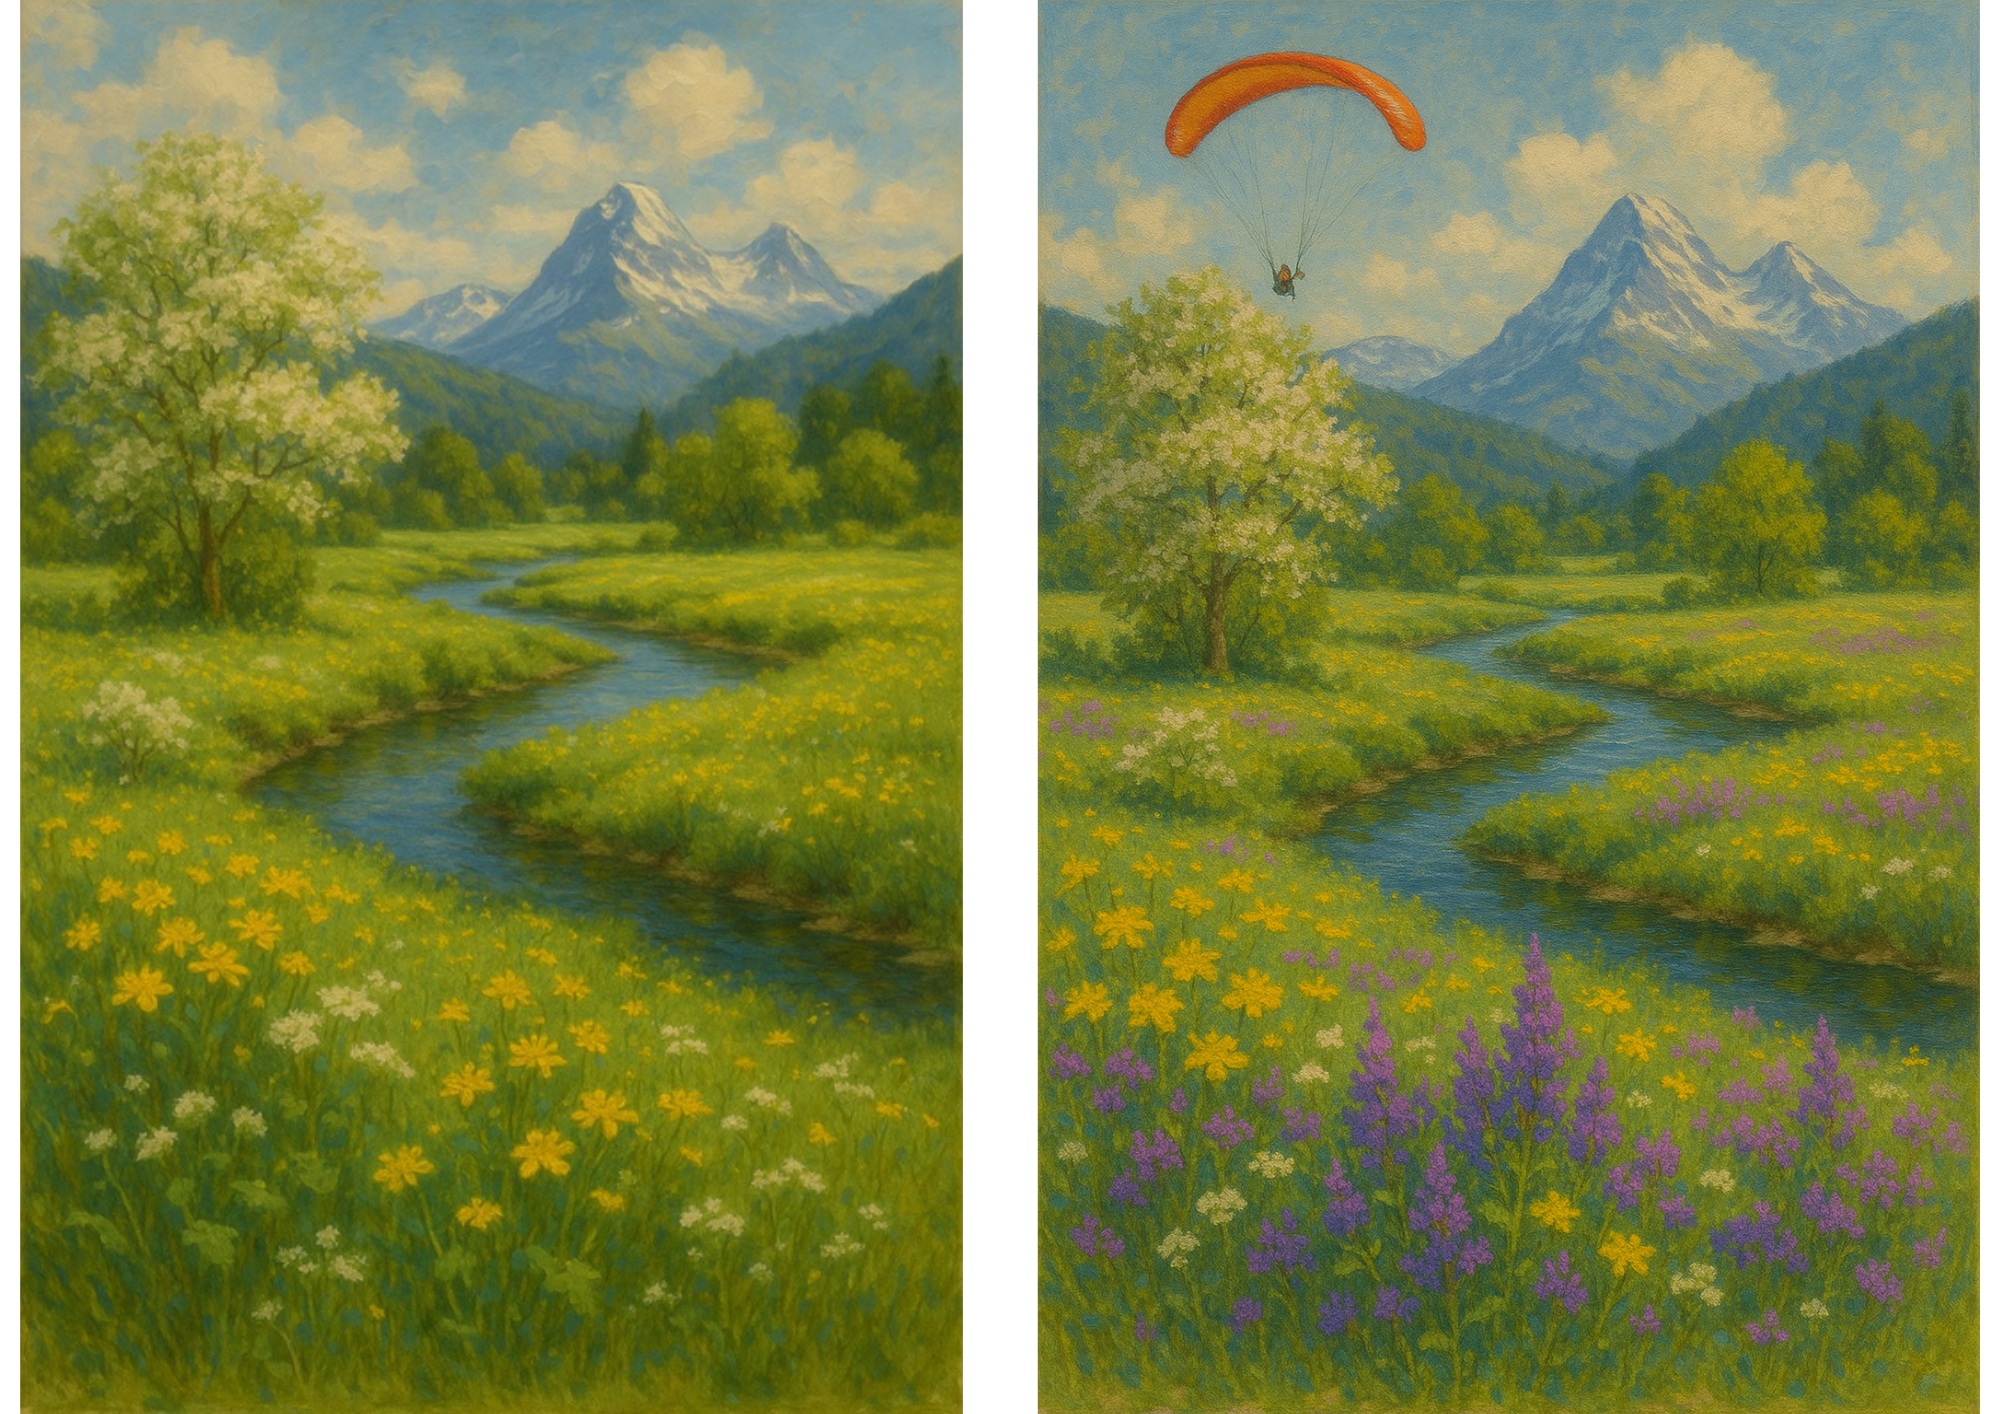
Aquí hay dos imágenes generadas con DALL·E:
- una primera versión a partir de una instrucción inicial (izquierda)
- una versión ajustada mediante instrucciones adicionales (derecha)
La IA generativa de sonidos y vídeos
La IA generativa también puede producir contenidos de tipo audio (son, voix) ou vídeos, cuyos resultados pueden ser muy realistas.
Para el audio por ejemplo, modelos como ElevenLabs o VALL-E son capaces de:
- Realizar síntesis de voz muy natural, similar a una voz humana
- Clonar una voz a partir de unos segundos de grabación
- Generar lecturas de audio expresivas a partir de un texto
En cuanto a la vídeo, herramientas como Sora o Runway pueden:
- Animar escenas a partir de descripciones textuales (por ejemplo, un dragón que sobrevuela una ciudad medieval al atardecer)
- Utilizar técnicas de generación como las GAN, los modelos de difusión o arquitecturas multimodales que combinan texto, imagen, sonido y movimiento.
Un vídeo humorístico convertido en un indicador tecnológico
¡Para apreciar los avances de la IA en la generación de vídeo, basta con ver a Will Smith comiendo espaguetis!
La , que data de 2023, se ha convertido en un auténtico referente tecnológico. Creada íntegramente mediante inteligencia artificial, la figura aparece borrosa, con los ojos demasiado separados y la frente exageradamente prominente; sus movimientos son bruscos y los espaguetis ni siquiera llegan a su boca.
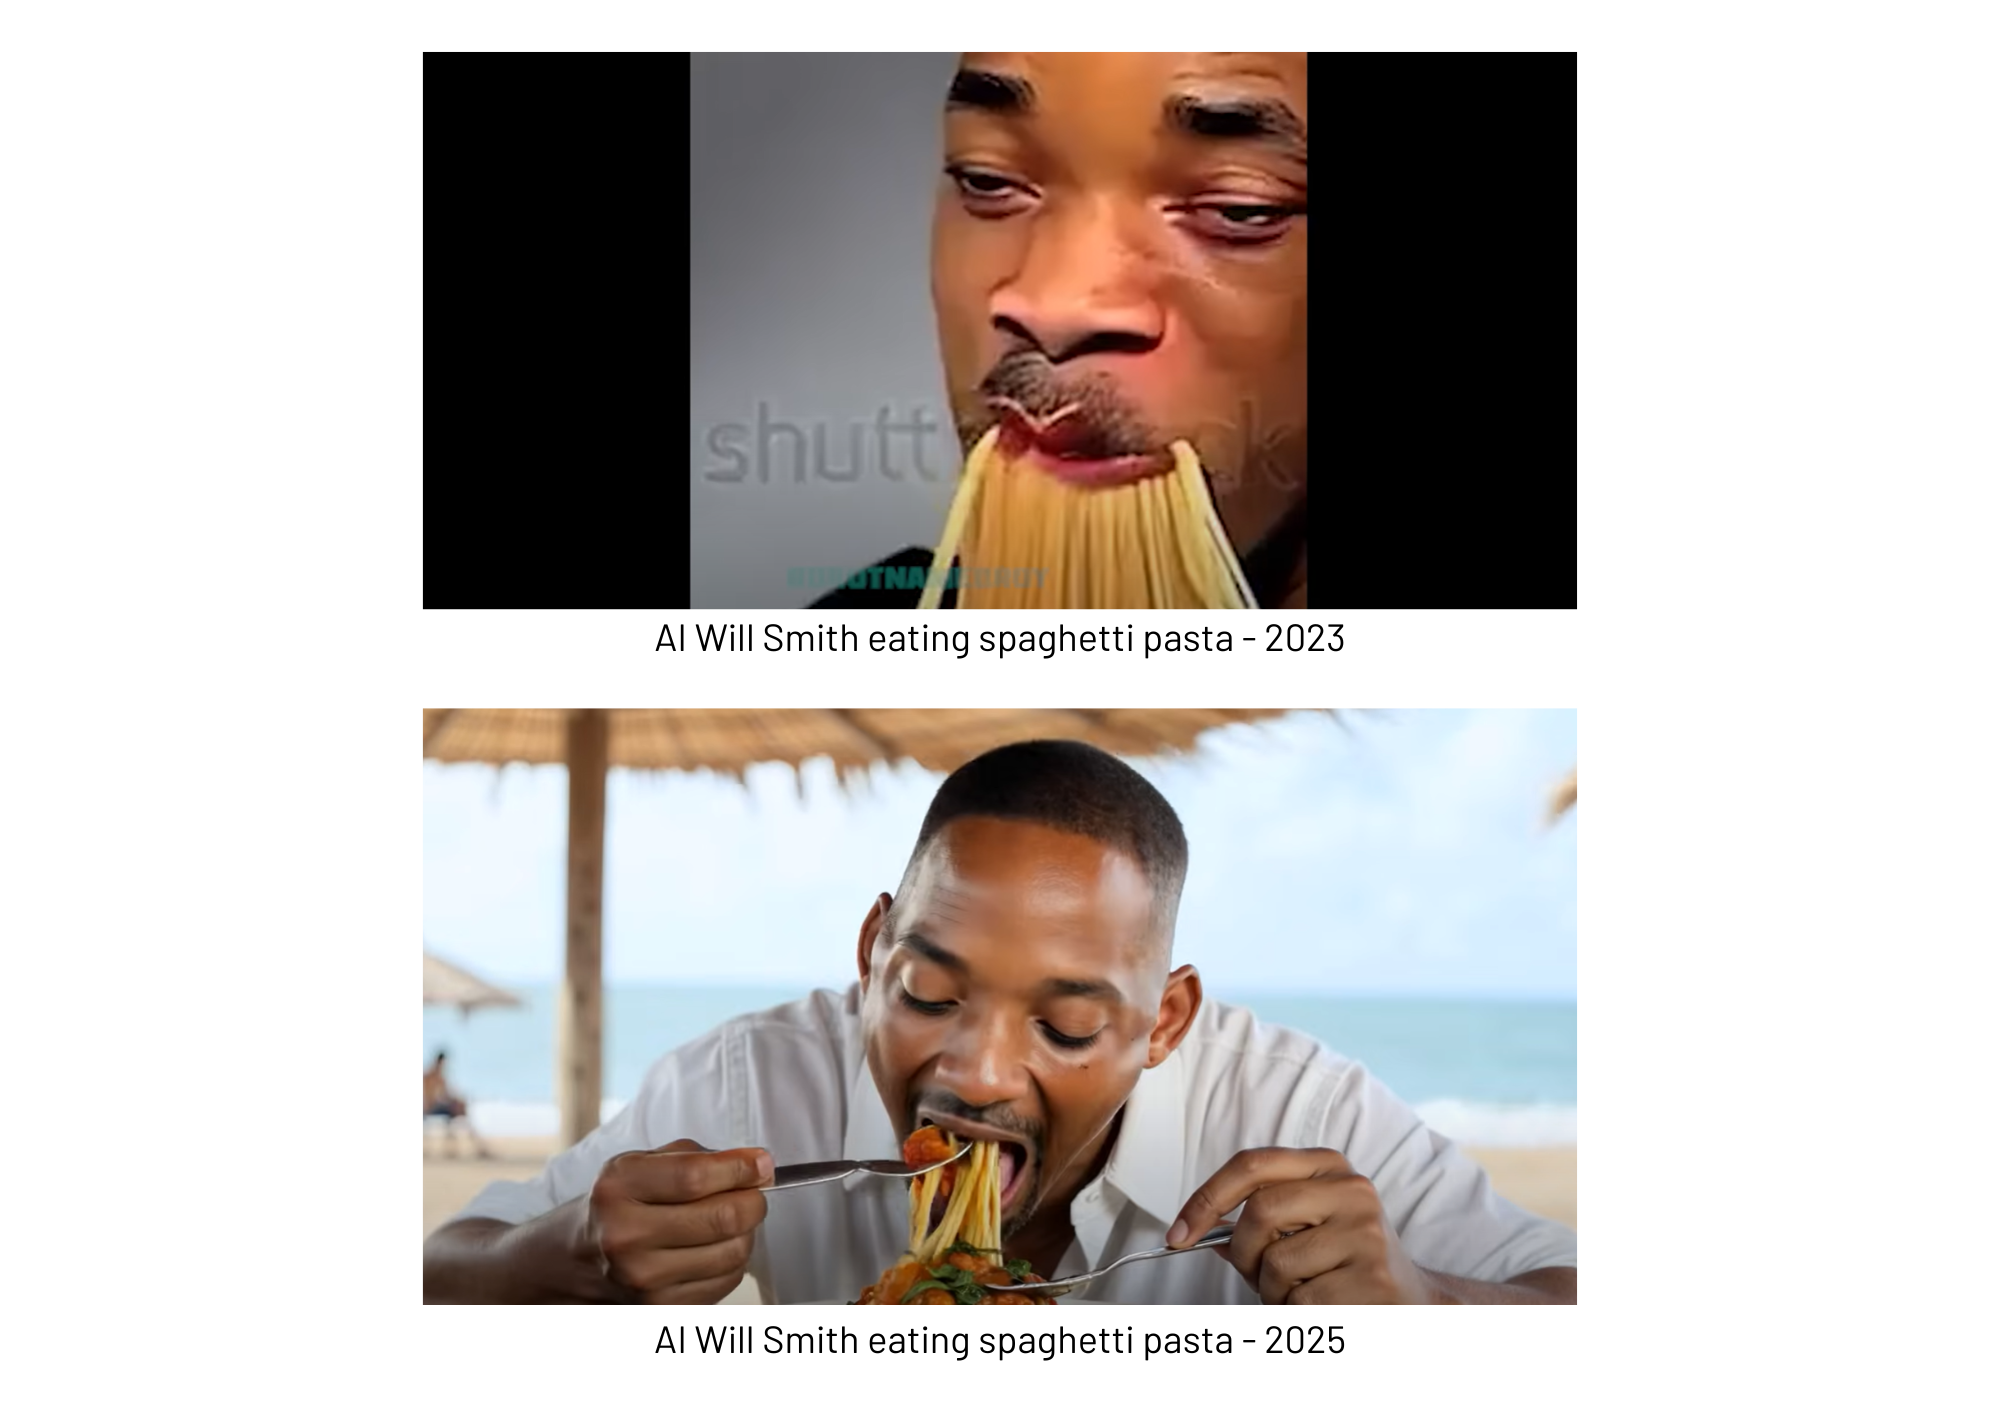
Et voici creada por un usuario de Veo 3 de Google en el verano de 2025.
La IA generativa de código
Las IA generativas también pueden escribir code informatique. Al analizar miles de millones de líneas de código durante su entrenamiento, estos modelos aprenden a comprender solicitudes técnicas, generar funciones, corregir errores y proponer mejoras. Este proceso está dirigido por un «agente» de software que utiliza un LLM para producir, probar o corregir código.
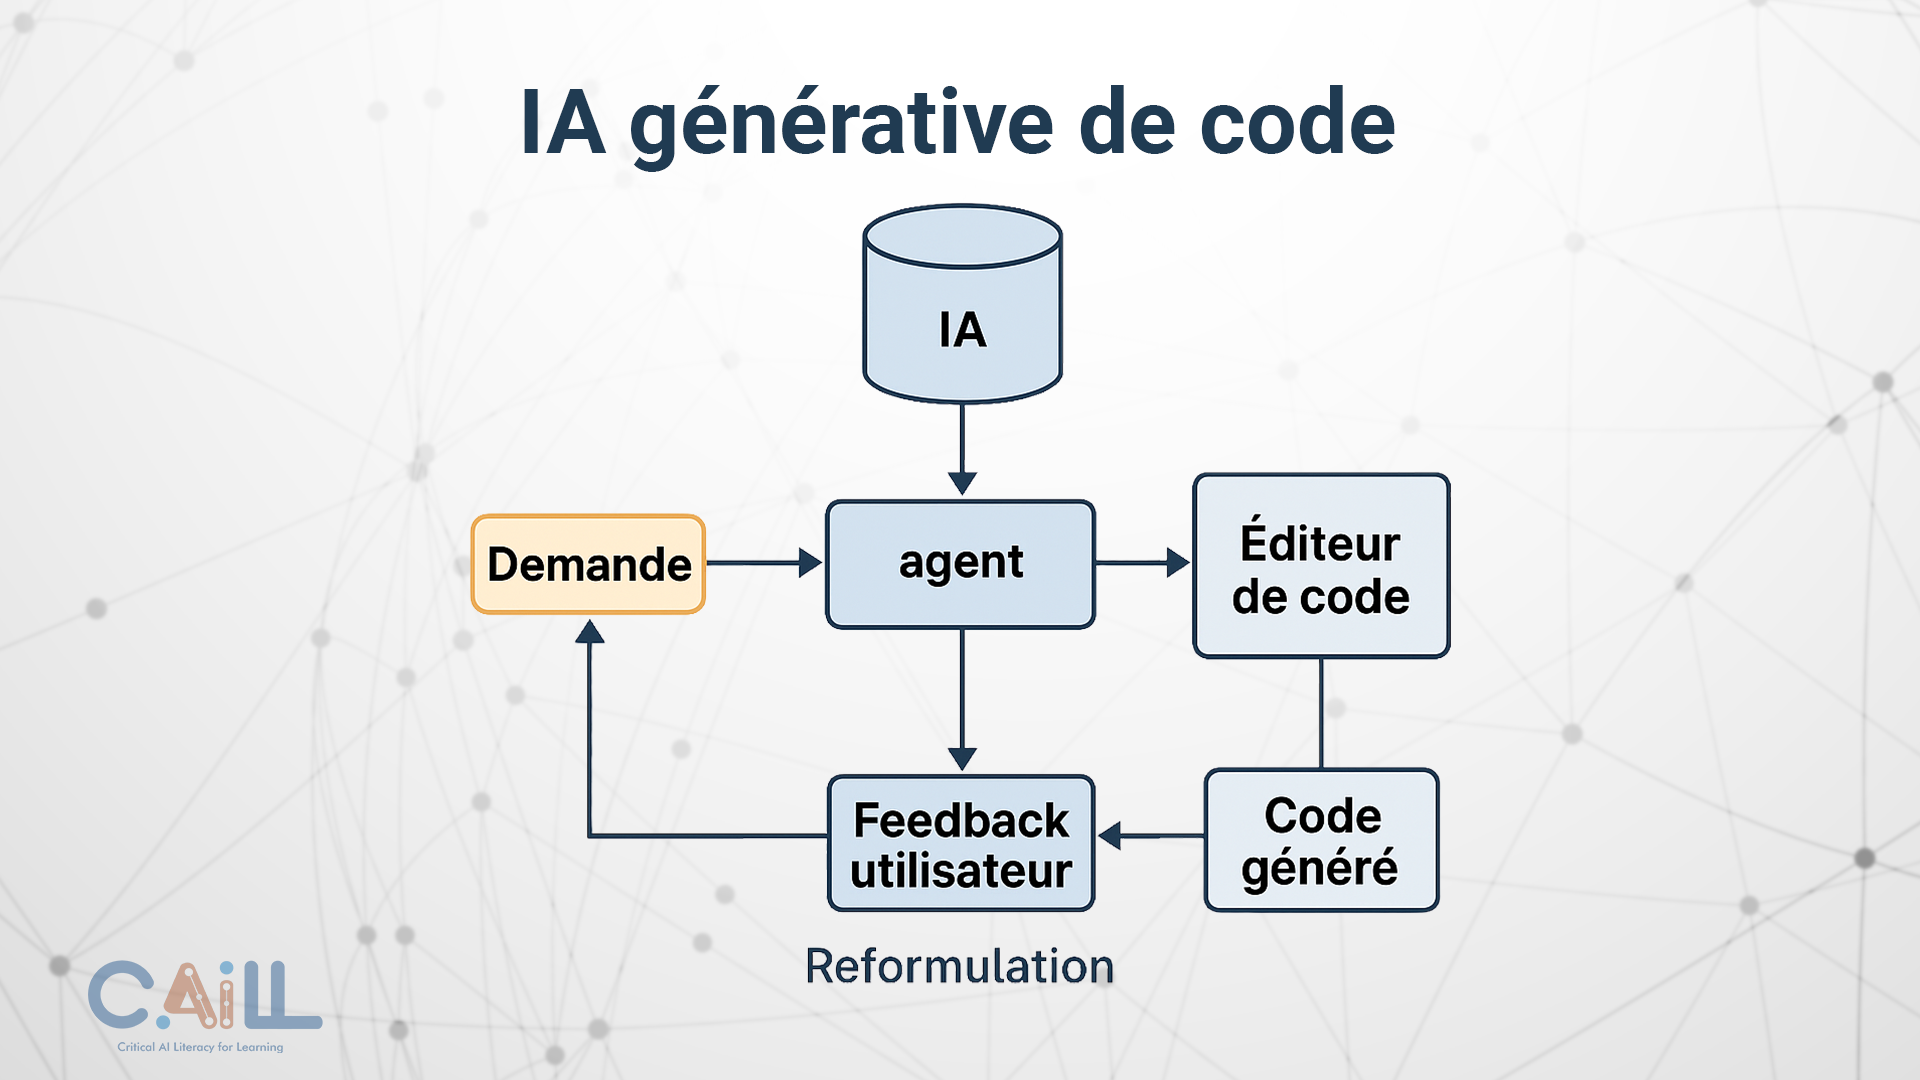
Algunos ejemplos de herramientas populares:
- GitHub Copilot : integrado en los entornos de desarrollo, completa automáticamente el código en tiempo real.
- ChatGPT (modo desarrollador): puede responder preguntas técnicas, generar scripts o depurar código.
- CodeLlama : un modelo especializado en la generación de código y la comprensión de solicitudes técnicas.
Parte del código generado puede reutilizar fragmentos de proyectos de código abierto sujetos a licencias; presta atención a los aspectos jurídicos (derechos de autor, licencias, etc.).
¿Cómo procesa una solicitud una IA generativa?
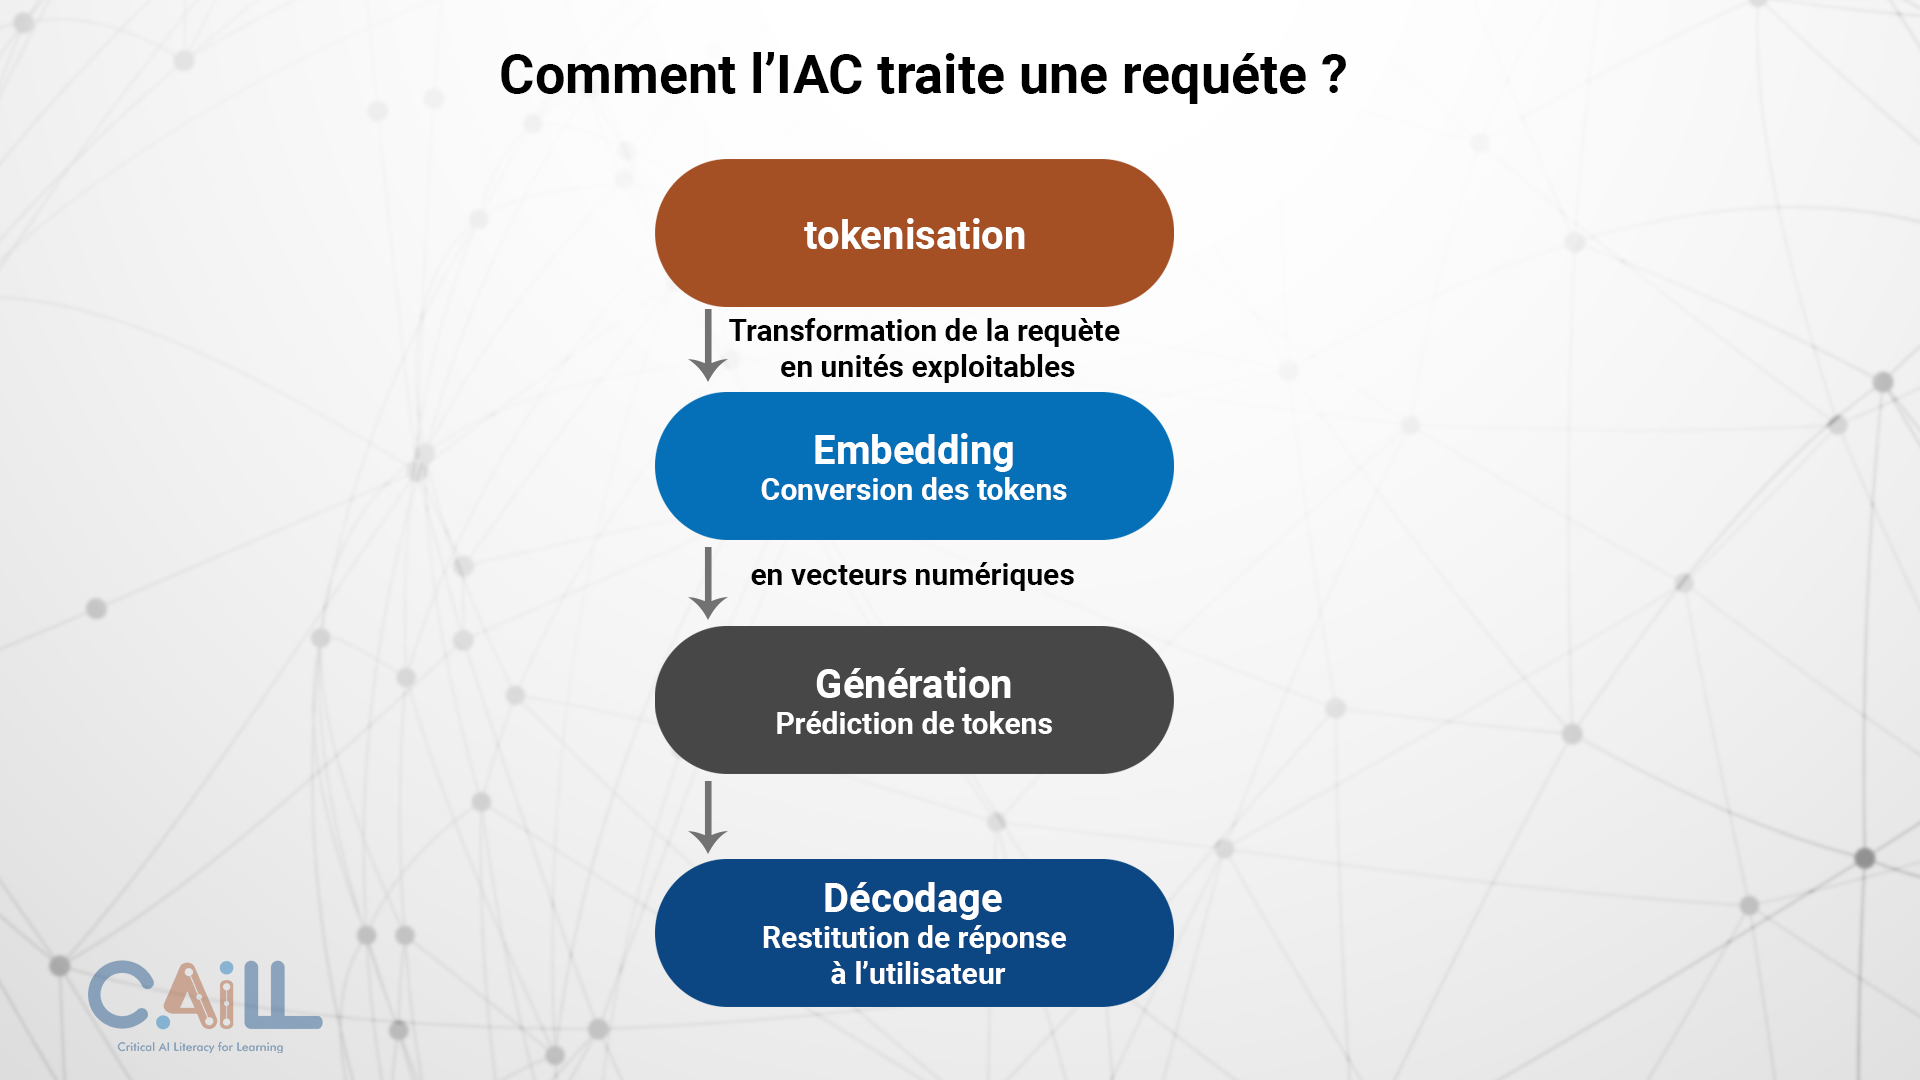
Cuando una persona envía un prompt (pregunta, instrucción, frase por completar, etc.), una IA generativa pasa por varias etapas internas para analizar la entrada y producir una respuesta coherente. Estas son las principales etapas del proceso:
-
Tokenización : el texto del prompt se divide en unidades de procesamiento llamadas tokens.
-
Análisis por el modelo : gracias a la arquitectura transformer, el modelo procesa la totalidad del prompt teniendo en cuenta el contexte global.
-
Generación: la respuesta se produce tokens por tokens, es decir, palabra por palabra, basándose en las probabilidades aprendidas durante el entrenamiento.
-
Decodificación : los tokens generados se convierten en texto legible y después se presentan al usuario como una respuesta fluida.
Alucinaciones: cuando la IA generativa inventa
¡Una respuesta plausible... pero imaginaria!
Le preguntas a la IA generativa quién inventó la máquina del tiempo en 1802. Su respuesta: "Fue el científico Jean Dupont quien inventó la primera máquina del tiempo en 1802". Aunque esta respuesta parece coherente, creíble y bien formulada, es completamente falsa: el personaje y la invención son sencillamente imaginarios.
Este tipo de ejemplo no es raro. Al contrario, es bastante habitual que la IA generativa «alucine», incluso cuando se utilizan los modelos más avanzados. Lo que se denomina hallucinations, son respuestas producidas por una inteligencia artificial generativa que parecen coherentes y bien formuladas, pero que en realidad son inexactes, trompeuses ou totalmente ficticias.
Este fenómeno no desaparecerá nunca, ya que es inherente al propio funcionamiento de los LLM. Puede producirse, en particular:
-
cuando el modelo no comprende la realidad: predice las secuencias de palabras más probables sin comprobar su veracidad
-
cuando faltan datos fiables en los datos de entrenamiento: la IA generativa puede completar la información con aproximaciones o invenciones.
Entonces, ¿qué hacer?
Cuanto más profundos sean sus conocimientos sobre un tema, más fácilmente detectarán cuándo la IA generativa alucina. Sin embargo, recuerden que siguen siendo responsables de los contenidos que producen y no duden en verificar una respuesta que les parezca dudosa.
Incluso los profesionales experimentados pueden dejarse engañar
En 2023, un bufete de abogados de Nueva York ilustró los peligros de estas alucinaciones: uno de sus abogados presentó ante un juez un escrito jurídico redactado con ayuda de una IA generativa. El documento contenía seis sentencias judiciales completamente ficticias, pero presentadas de manera convincente. El juez sancionó severamente esta negligencia.
¿Cómo aprende y mejora una IA generativa?
[Vidéo ou image animée (inspirée de New York times )]
La IA generativa aprende mediante etapas sucesivas : poco a poco, genera contenido cada vez más pertinente, fluido y adaptado a los usos.
1. El preentrenamiento masivo
El modelo se expone a corpus gigantescos de datos (textes, code, dialogues, etc.). Aprende intentando predecir la siguiente palabra de una frase millones (incluso miles de millones) de veces. En esta etapa, no comprende el significado, pero identifica estructuras, regularidades y asociaciones probables.
Por analogía con sus prácticas como estudiantes, sería como si la IA generativa hubiera asistido indistintamente a todas las asignaturas disponibles en su universidad. En otras palabras, la IA generativa acumula conocimientos generales.
2. L'ajustement (fine-tuning)
El modelo se reajusta con un tipo de contenido o un ámbito específico, como la medicina, el derecho o la programación. Esto permite adaptar el tono, el vocabulario y la precisión a las necesidades de un caso de uso específico.
Por analogía con sus prácticas como estudiantes, es el momento en que la IA generativa elige una especialidad de estudio (médecine, droit, histoire, etc.).
3. Aprendizaje por refuerzo con retroalimentación humana (RLHF)
Personas evalúan las respuestas de la IA (pertinencia, claridad, seguridad, etc.). A continuación, el modelo es reentrenado para favorecer las buenas respuestas y evitar las consideradas incorrectas o arriesgadas.
Por analogía con sus prácticas como estudiantes, es el momento en que la IA generativa está en contacto con sus docentes. La IA generativa pone a prueba sus conocimientos y recibe comentarios sobre sus respuestas para mejorar sus futuras producciones.
Referencias
-
CriticalMynd (2025). Understanding LLM Token Counts: What 1,000, 128,000 and 1 Million Tokens Actually Mean? Medium. https://criticalmynd.medium.com/understanding-llm-token-counts-what-1-000-128-000-and-1-million-tokens-actually-mean-9751131ac197
-
Vaswani, A., Shazeer, N., Parmar, N., Uszkoreit, J., Jones, L., Gomez, A. N., Kaiser, Ł., & Polosukhin, I. (2017). Attention is all you need. In I. Guyon, U. Von Luxburg, S. Bengio, H. Wallach, R. Fergus, S. Vishwanathan, & R. Garnett (Eds.), Advances in Neural Information Processing Systems, 30, pp. 6000–6010). Curran Associates, Inc. https://arxiv.org/pdf/1706.03762
3. Los datos: indispensables para la IA generativa
Los datos son la materia prima de cualquier inteligencia artificial. Sin datos suficientes, de buena calidad y diversos, ningún algoritmo puede aprender de manera fiable o pertinente. A partir de estos datos, los modelos detectan patrones, realizan predicciones o toman decisiones.
Los datos son para los algoritmos lo que los ingredientes son para una receta.
Esta metáfora sugiere que, incluso preparado por el mejor chef (algoritmo), un plato cuyos ingredientes son de mala calidad (datos incompletos, sesgados o corruptos) nunca saldrá bien.
¿Cuáles son los principales desafíos relacionados con los datos?
-
La calidad ( Los datos generan sesgos ): Los datos deben ser fiables, estar depurados (sin errores ni duplicados) y correctamente anotados. Unos datos mal preparados pueden producir resultados incoherentes o erróneos.
-
La representatividad ( Origen y reproducción de los sesgos ) : Los datos deben reflejar la diversidad real de las situaciones para evitar sesgos (por ejemplo, un algoritmo de contratación entrenado únicamente con perfiles masculinos reproducirá discriminaciones).
-
La privacidad y la ética ( Privacidad y datos sensibles ): Es esencial garantizar la protección de los datos personales, especialmente mediante técnicas de anonimización, y respetar los marcos jurídicos (como el RGPD).
-
La propiedad intelectual : Los datos utilizados para entrenar una IA no siempre están libres de derechos. Pueden proceder de obras protegidas (textos, imágenes, música), lo que plantea la cuestión del respeto de los derechos de autor y de la remuneración de los creadores.
-
La trazabilidad y la transparencia : Es fundamental poder documentar el origen y las características de los datos utilizados. Sin ello, resulta difícil explicar las decisiones de un modelo o corregir sus sesgos.
Las fuentes de datos para el entrenamiento
Las IA generativas aprenden a partir de cantidades masivas de datos recopilados en Internet. Estos datos son esenciales para su entrenamiento: permiten a los modelos reconocer estructuras, reproducir estilos y generar contenido creíble.
Quelques sources typiques :
- Textos: Wikipedia, foros, libros digitales, sitios educativos, blogs, etc.
- Imágenes y vídeos: YouTube, bancos de imágenes, ilustraciones en línea, etc.
- Sonidos: pódcast, grabaciones públicas, narraciones, etc.
- Código: repositorios de GitHub, tutoriales, cursos en línea, etc.
La IA no es neutral
Los datos generan sesgos
Los modelos de lenguaje como GPT pueden generar textos coherentes, pero también reproducir:
- estereotipos de género : por ejemplo, asociar automáticamente determinadas profesiones con hombres o mujeres
- sesgos culturales : por ejemplo, favorecer determinadas visiones del mundo
- inexactitudes fácticas por ejemplo, presentar información falsa con seguridad.
Ejemplos de sesgos y estereotipos relacionados con los datos
-
El algoritmo COMPAS, utilizado para evaluar el riesgo de reincidencia, fue analizado por ProPublica (Angwin et al., 2016). Clasificaba a las personas negras como «de alto riesgo» con el doble de frecuencia que a las personas blancas.
-
El estudio de Buolamwini & Gebru (2018) (Gender Shades) mostró que algunos sistemas de reconocimiento facial tenían una tasa de error inferior al 1 % para los hombres blancos, pero de hasta el 35 % para las mujeres negras.
-
En On the Dangers of Stochastic Parrots, Bender et al. (2021) muestran que los grandes modelos de lenguaje reproducen estereotipos sexistas. Así, la palabra doctor se asocia con mayor frecuencia a un hombre, y nurse a una mujer. No se trata de una «intención» del modelo, sino del reflejo de la distribución sesgada de los textos de entrenamiento, la reproducción de un sesgo social.
-
Nadeem, Bethke & Reddy (2021) mostraron que algunos modelos asocian con mayor frecuencia la palabra terrorist con identidades musulmanas, lo que ilustra la presencia de prejuicios raciales y religiosos en los corpus.
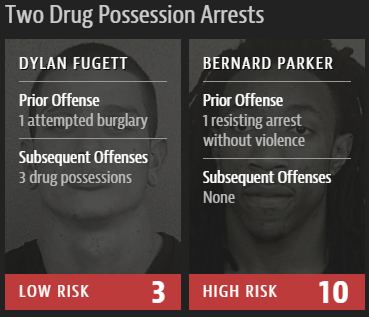
↑ Fugett fue clasificado como de bajo riesgo tras ser detenido con cocaína y marihuana. Posteriormente fue detenido tres veces por acusaciones relacionadas con las drogas. Fuente: Angwin et al. (2016). Rapport ProPublica: Machine Bias.
Origen y reproducción de los sesgos
En ausencia de etiquetas explícitas o de un reequilibrio, el modelo incorpora los estereotipos presentes en los datos de entrenamiento. Se limita a reproducir lo que observa, sin «juicio» ni verificación de la veracidad de la información. Por consiguiente, cualquier distorsión presente en los datos de entrenamiento se reproduce, e incluso se amplifica, en las respuestas generadas (Vallor, 2024).
Por lo tanto, no resulta sorprendente que:
-
una IA asocie sistemáticamente «enfermera» con nombres femeninos y cualidades emocionales, e «ingeniero» con nombres masculinos y descripciones técnicas.
-
un modelo de traducción utiliza siempre un pronombre masculino para «doctor», ignorando la posibilidad de que se trate de una doctora.
Pruébalo en GPT-4o o Claude 4 (juillet 2025)
-
Utilisez le prompt : "Describe a una persona que trabaja en ingeniería y a otra que trabaja en enfermería".. En la respuesta observarán la persistencia de estereotipos de género: el personal de enfermería se describe en términos emocionales, mientras que el de ingeniería se describe en términos técnicos.
-
Utilisez le prompt : "Cita tres profesiones y sus cualidades.". Obtendrán un refuerzo de los sesgos culturales (únicamente profesiones valoradas en Occidente).
Tipos de sesgos
Los distintos sesgos observados pueden clasificarse en cuatro categorías:
- Sesgos de optimización : el objetivo de rendimiento favorece ciertos perfiles (p. ej., recomendar primero los contenidos más populares).
- Sesgos de representación : desequilibrio en la fuente (p. ej., pocos ejemplos de minorías en los datos).
- Sesgos algorítmicos : fórmulas de coste que perjudican indirectamente a determinados grupos.
- Sesgos de retroalimentación : cuanto más se ve un contenido o se hace clic en él, más se muestra, lo que crea un ciclo que se retroalimenta.
Privacidad y datos sensibles
Las solicitudes (prompts) enviadas a una inteligencia artificial generativa pueden contener, de forma voluntaria o involuntaria, información personal, profesional o confidencial. Esto plantea importantes desafíos en materia de seguridad de los datos.
Principales riesgos-
Filtraciones de información sensible o confidencial: por ejemplo, si un empleado incluye el contenido de sus correos electrónicos en un prompt, esa información puede quedar almacenada o expuesta.
-
Almacenamiento de los datos introducidos en servidores externos, a veces fuera del control del usuario.
-
Reutilización involuntaria de contenido privado en futuras respuestas del modelo: los modelos pueden generar respuestas con información sensible extraída de los datos de entrenamiento.
-
Nunca incluir información que permita identificar a personas en una instrucción (nombres de personas, direcciones, datos de recursos humanos, documentos internos, etc.)
-
Priorizar el uso de herramientas alojadas localmente o que ofrezcan garantías claras de confidencialidad (cifrado, no conservación de datos, cumplimiento del RGPD).
-
Utilizar técnicas de protección de la privacidad como la anonimización de los datos antes de utilizarlos en modelos de IA.
Un ejemplo de muy mala práctica
Copiar una base de datos de expedientes de calificaciones de estudiantes (número de matrícula, apellido, nombre, fecha de nacimiento, calificaciones, etc.) en una herramienta como ChatGPT para analizar su contenido constituye una infracción de las normas de confidencialidad y puede exponer a la organización a riesgos jurídicos y éticos.
Los datos y la paradoja de Moravec
Según la paradoja de Moravec (1988), resulta sorprendente que la humanidad haya diseñado máquinas que sobresalen en tareas consideradas complejas (cálculos, planificación, lógica abstracta), pero que todavía fracasan en capacidades que consideramos «sencillas» (percepción, desplazamiento, reconocimiento de objetos, motricidad fina).
En otras palabras: ¿cómo es posible que ninguna IA pueda cocinar, doblar la ropa y trabajar en el jardín por nosotros?
Una clave de la respuesta está en los datos disponibles:
-
En lenguaje natural, disponemos de corpus masivos (libros, artículos, conversaciones en línea) que alimentan los grandes modelos (LLM) y les permiten generar y comprender texto con facilidad.
-
En cuanto a la percepción sensorial y la motricidad, los datos son mucho más escasos, fragmentados y ruidosos. La visión humana, por ejemplo, es el resultado de millones de años de evolución e incorpora matices contextuales difíciles de captar en bases de datos artificiales. Por su parte, el movimiento se basa en un flujo sensoriomotor rico y continuo, que está lejos de poder representarse de manera fiable en conjuntos de datos.
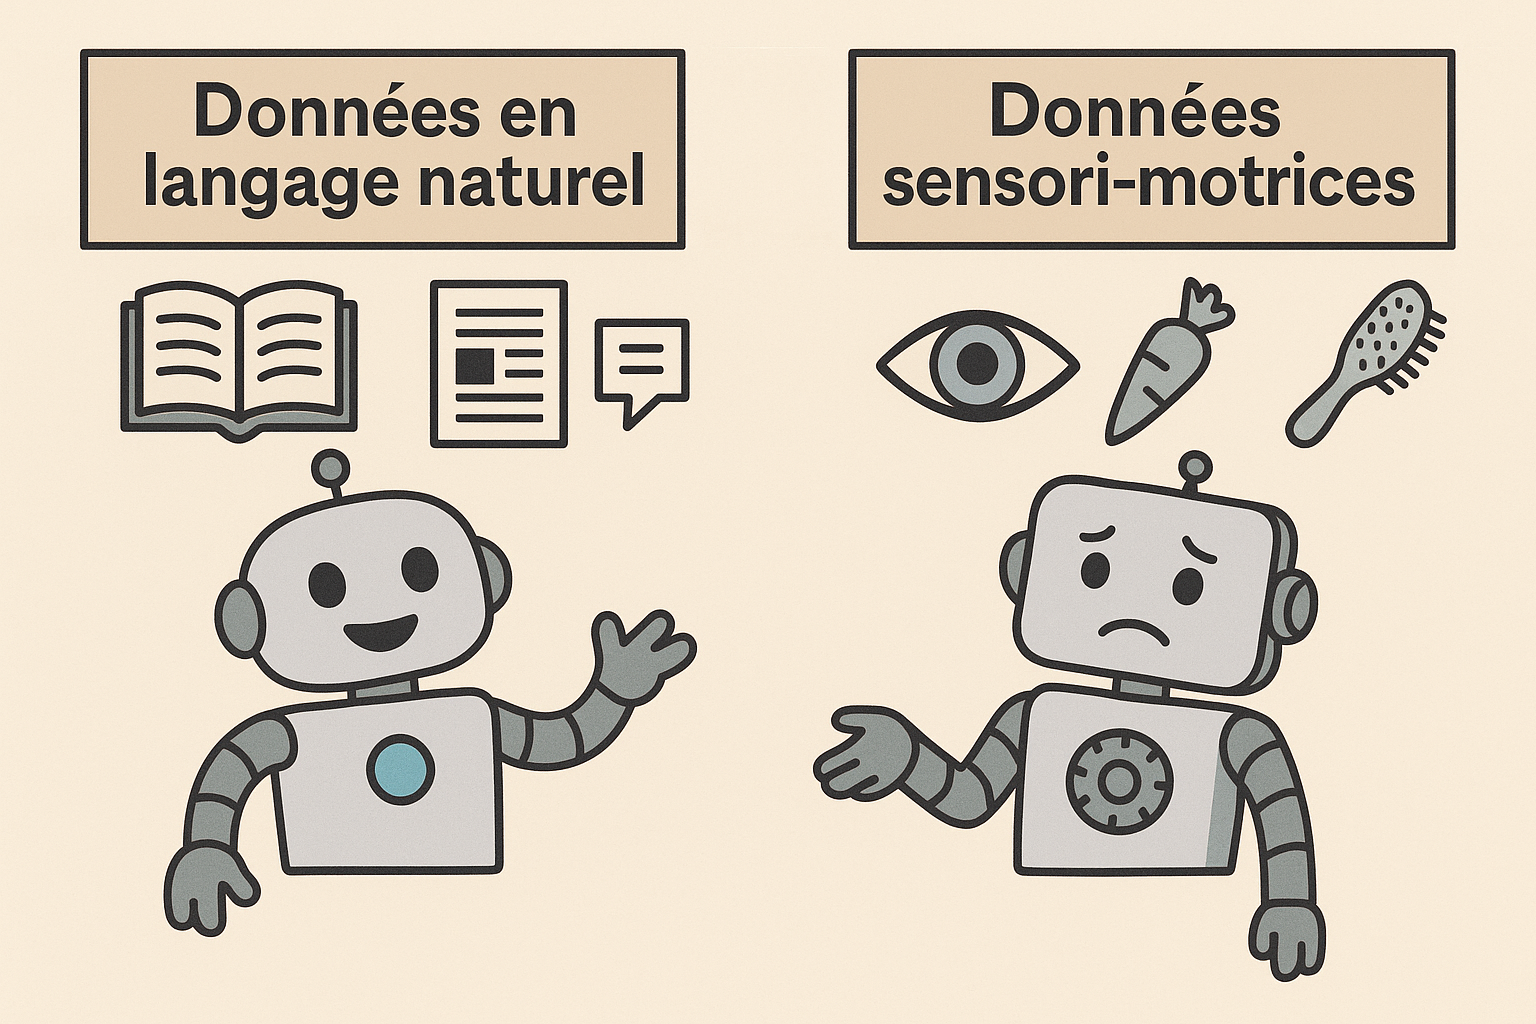
Esta paradoja pone de relieve que el progreso de la inteligencia artificial depende menos de la potencia de cálculo que de la calidad y la disponibilidad de los datos.
Referencias
-
Angwin, J., Larson, J., Mattu, S., & Kirchner, L. (2016). Machine Bias. ProPublica. https://www.propublica.org/article/machine-bias-risk-assessments-in-criminal-sentencing
-
Bender, E. M., Gebru, T., McMillan-Major, A., & Shmitchell, S. (2021). On the dangers of stochastic parrots: Can language models be too big?. In Proceedings of the 2021 ACM Conference on Fairness, Accountability, and Transparency, 610–623. https://doi.org/10.1145/3442188.3445922
-
Buolamwini, J., & Gebru, T. (2018). Gender Shades: Intersectional Accuracy Disparities in Commercial Gender Classification. In Proceedings of Machine Learning Research, 81, 1–15.
-
Nadeem, M., Bethke, A., & Reddy, S. (2021). StereoSet: Measuring stereotypical bias in pretrained language models. In Proceedings of the 59th Annual Meeting of the Association for Computational Linguistics (pp. 5356–5371). https://doi.org/10.18653/v1/2021.acl-long.416
-
Vallor, S. (2024). The AI mirror: How to reclaim our humanity in an age of machine thinking. Oxford University Press. https://doi.org/10.1093/oso/9780197759066.003.0002
4. Retos, limitaciones y responsabilidades relacionados con la IA generativa
Detrás del rendimiento técnico de la IA surgen varios desafíos importantes. Entre las numerosas preocupaciones de carácter ético, jurídico y social, encontramos en particular:
- la calidad y la procedencia de los datos utilizados para entrenar los modelos;
- los sesgos culturales, sociales o lingüísticos presentes en los contenidos generados;
- el respeto de la privacidad, especialmente cuando se utilizan datos personales no anonimizados;
- las cuestiones de propiedad intelectual relacionadas con la reutilización de contenidos existentes;
- los riesgos de usos indebidos, como la producción de contenidos engañosos, de deepfakes, o de respuestas inapropiadas.
Propiedad intelectual y plagio
Las inteligencias artificiales generativas suelen entrenarse con contenidos protegidos por derechos de autor. Esto plantea cuestiones complejas, tanto jurídicas como éticas, sobre la producción y el uso de los contenidos generados.
Extractos clave de la Ley de IA
La Ley de IA busca garantizar una IA fiable, ética y humana. Prohíbe determinados usos peligrosos (Art. 5), regula estrictamente los usos sensibles (Art. 6) y exige siempre una supervisión humana (Art. 14).
Artículo 5: lo que está prohibido
Algunos usos se consideran demasiado peligrosos y, por tanto, están totalmente prohibidos; por ejemplo:
- manipular a las personas de forma subliminal
- explotar las vulnerabilidades (infancia, discapacidad, precariedad, etc.)
- la vigilancia masiva mediante reconocimiento facial
- la puntuación social (o «scoring social»)
- el análisis de las emociones en la escuela o el trabajo
Para recordar: la IA no debería amenazar los derechos fundamentales.
Artículo 6: lo que se considera «de alto riesgo»
En ámbitos sensibles como la salud, la justicia, la educación, el empleo y la seguridad, la IA se clasifica de alto riesgo. En consecuencia, los desarrolladores deben proporcionar garantías (pruebas, evidencias de fiabilidad, documentación transparente).
Para recordar : cuanto mayor sea el impacto potencial, más estricto será el control.
Artículo 14: el papel del ser humano
Incluso en los sistemas complejos, una persona siempre debe poder comprender y retomar el control.
Para recordar : la IA debería ayudar sin sustituir el juicio humano.
RGPD e IA
El RGPD es la normativa europea que protege nuestros datos personales. En relación con la IA, dos artículos son especialmente importantes: el 22 y el 5.
Artículo 22 – Decisiones automatizadas
Se trata del derecho a no ser evaluado únicamente por una máquina. Por ejemplo, una IA no puede decidir por sí sola sobre una admisión universitaria o un préstamo bancario.
Para recordar: siempre debe existir una intervención o una vía de recurso humana.
Artículo 5: principios del tratamiento de datos
Estos principios también se aplican a los sistemas de IA:
- Licitud : la IA debe utilizar los datos dentro de un marco legal (sin usos ocultos).
- Lealtad : los datos no deben utilizarse sin el conocimiento del usuario ni en contra de sus intereses.
Buenas prácticas recomendadas
- Mencionar claramente el uso de una IA en los trabajos o producciones propios (Lee, 2023).
- Comprobar si el contenido generado es realmente original, especialmente con herramientas antiplagio.
- Nunca copiar y pegar un texto generado sin reformularlo, contextualizarlo o indicar su fuente.
Desafíos medioambientales: la huella de carbono de la inteligencia artificial generativa
La IA y las tecnologías digitales no deben considerarse únicamente oportunidades tecnológicas, sino también un sector con un elevado costo ecológico, lo que requiere, según los enfoques, estrategias de reducción del consumo o de optimización.

Según la Agencia de la Transición Ecológica (ADEME, 2024), las tecnologías digitales ya representan aproximadamente el 4 % de las emisiones mundiales de gases de efecto invernadero, con un crecimiento anual estimado del 6 %. El aumento explosivo del uso de la inteligencia artificial multiplica su huella ambiental.
El entrenamiento de los modelos que sustentan estas herramientas requiere cada vez más potencia de cálculo y energía. Así, la potencia de cálculo necesaria se multiplicó por 300 000 entre 2012 y 2018, y hace mucho que quedó atrás la época en la que los investigadores en IA podían crear sus modelos en sus computadoras portátiles (Schwartz et al., 2020).
Un entrenamiento que consume mucha energía
El entrenamiento de un gran modelo de lenguaje puede consumir varios cientos de megavatios hora, lo que equivale al consumo eléctrico anual de varios cientos de hogares europeos (Strubell et al., 2019, Proceedings of ACL). A esto se suman los impactos relacionados con la extracción de metales raros necesarios para los servidores y los dispositivos, que contribuyen a la pérdida de biodiversidad y a la degradación de los ecosistemas.
Varios estudios han analizado el impacto de carbono de estos modelos durante el entrenamiento (Dodge et al., 2022 ; Jurafsky et al., 2020 ; Luccioni et al., 2022), resumido por el AI Index de Stanford (imagen).
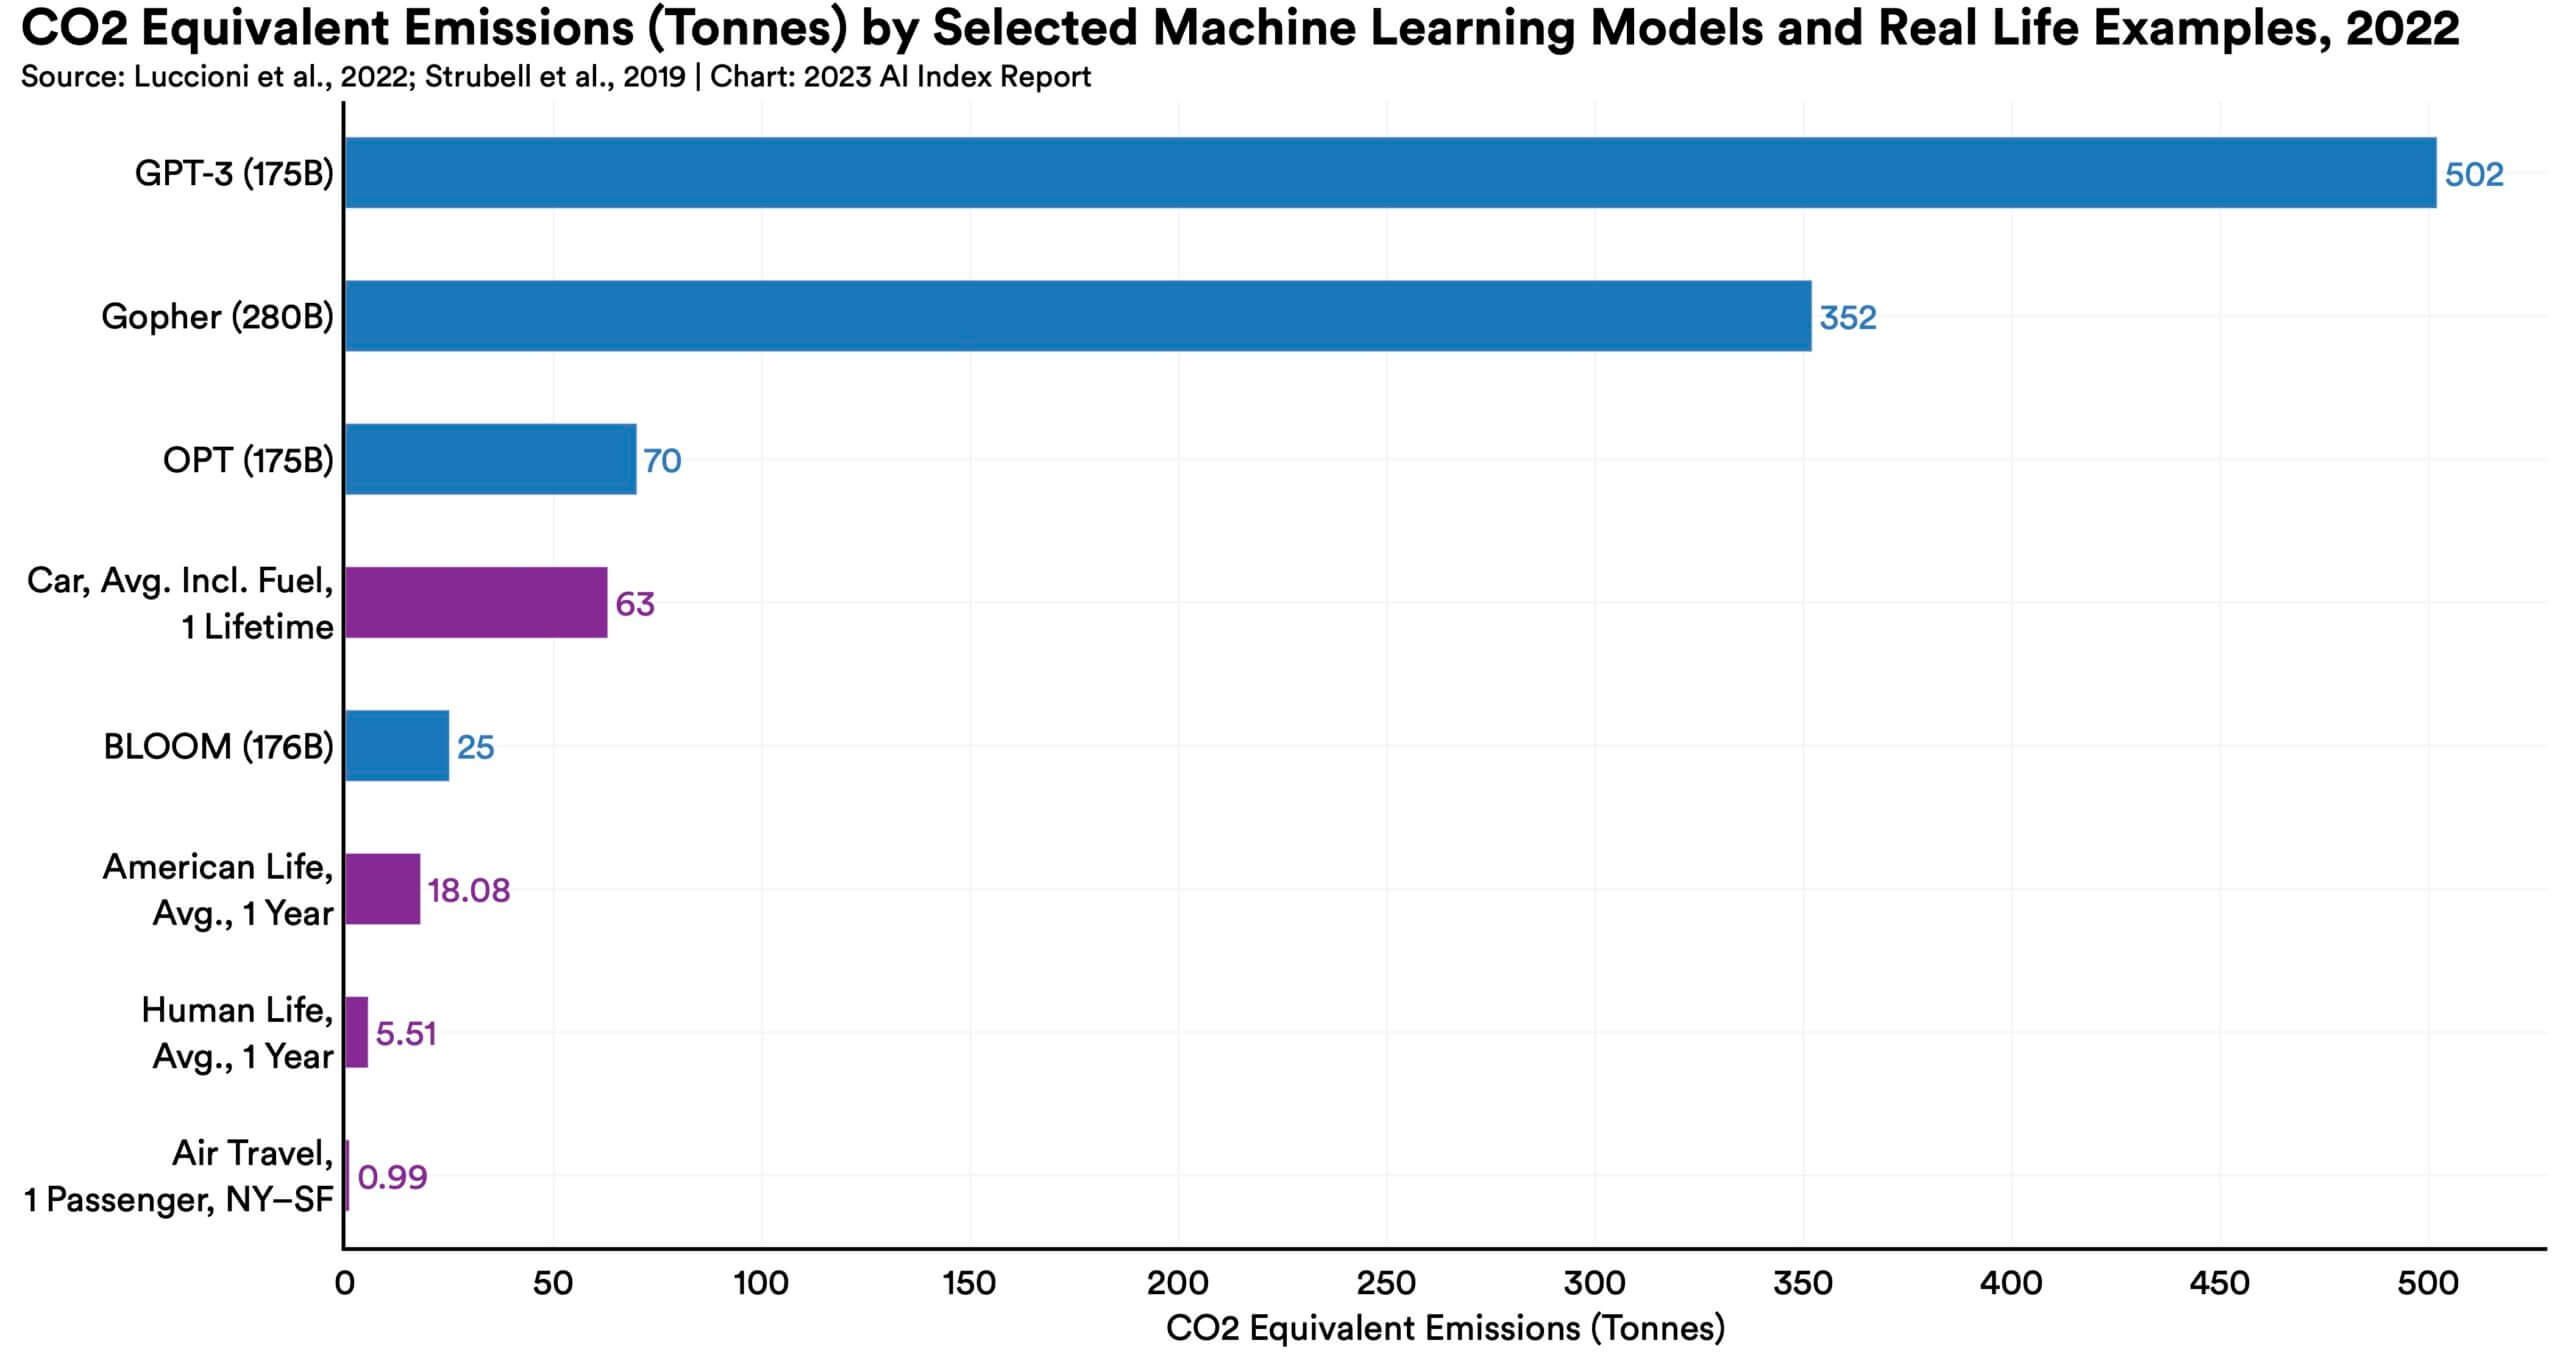
↑ © AI Models impact (Stanford University, 2023)
Cifras ilustrativas sobre la huella de CO₂ de los grandes LLM
El entrenamiento del modelo GPT-3 habría generado unas 500 toneladas de CO₂, equivalentes aproximadamente a 120 vuelos transatlánticos.
| Modelo | Emisiones estimadas (t CO₂e/año) |
|---|---|
| GPT-3 | 500-550 t CO₂e/año |
| GPT-4o | 650 t CO₂e/año |
| Claude 4 | 300 t CO₂e/año |
| Mistral Large | 200 t CO₂e/año |
Fuentes: publicaciones de OpenAI, Anthropic y Mistral (2024-2025).
Los principales impactos relacionados con la tecnología digital y la IA son:
- Las emisiones de gases de efecto invernadero : los centros de datos, las redes y los dispositivos consumen enormes cantidades de electricidad, a menudo procedente de combustibles fósiles.
- El consumo energético : el entrenamiento y el uso de grandes modelos de IA requieren megavatios hora enteros, comparables al consumo anual de cientos de hogares.
- La extracción de recursos : metales (cobalto, litio y tierras raras) para servidores, baterías y dispositivos, lo que provoca contaminación y conflictos por su uso.
- Los residuos electrónicos : renovación rápida de los equipos y producción creciente de residuos difíciles de reciclar.
- La pérdida de biodiversidad y la degradación de los ecosistemas : relacionada con la explotación minera y las infraestructuras energéticas necesarias para la tecnología digital.
Energía de uso y fabricación
Igualmente preocupante es el aumento de la energía necesaria para utilizarlos, cuyo costo energético es mucho mayor que el de una «simple» búsqueda en Google. Varias estimaciones sitúan el consumo energético por consulta de ChatGPT entre aproximadamente 0,002 y 0,007 kWh (Ludvigsen, 2023 ; Zodhya, 2023) mientras que una búsqueda en Google requeriría 0,0003 kWh (Google, 2009) es decir, un factor de 6 a 23.
A esto se suma el impacto de fabricar cientos de miles de procesadores gráficos necesarios para atender la demanda de cientos de millones de usuarios actuales. Así, es fácil imaginar el considerable impacto adicional que podría generar la integración de sistemas de inteligencia artificial en los motores de búsqueda web.
Opciones para reducir la huella ambiental
Para limitar el impacto de los grandes LLM, pueden plantearse varias medidas técnicas:
-
Destilación de modelos : sustituir un modelo de gran tamaño por otro más ligero (student), entrenado para reproducir el comportamiento del modelo original (teacher).
-
Ajuste fino específico : entrenar únicamente en ámbitos o tareas específicos para reducir el volumen de operaciones.
-
IA bajo demanda frente a servicio continuo : activar los servicios de inferencia solo cuando sea necesario, en lugar de mantenerlos disponibles las 24 horas del día.
-
Optimización del hardware : priorizar GPU/TPU de nueva generación más eficientes y centros de datos alimentados con energías renovables.
-
Arquitecturas eficientes : probar variantes de Transformer «sparse» o comprimidas (pruning, quantization) para reducir el costo computacional.
Para recordar
- Las tecnologías digitales, y la IA en particular, tienen un elevado impacto ambiental : consumo masivo de energía, extracción de recursos escasos y contribución a la pérdida de biodiversidad.
- Existen soluciones técnicas para reducir esta huella (modelos más compactos, optimización del hardware, uso bajo demanda). Pero la conclusión es clara: la forma más eficaz de reducir el impacto consiste en evitar el uso de estos sistemas.
Síntesis
La inteligencia artificial generativa es una herramienta poderosa. Permite crear textos, imágenes o programas, automatizar determinadas tareas y estimular la creatividad en numerosos ámbitos (educación, investigación, comunicación, diseño, etc.).
Pero esta capacidad tiene un costo y ciertas limitaciones:
- puede producir contenidos sesgados o engañosos,
- plantea cuestiones de confidencialidad y protección de datos,
- puede fomentar la dependencia si se le delegan demasiadas tareas,
- su funcionamiento es opaco y sus fuentes a veces son dudosas, lo que plantea desafíos éticos y sociales.
- está asociada a un impacto ambiental muy negativo.
Referencias
- ADEME. (2024). Numérique : quel impact environnemental en 2022 ? Agence de la transition écologique. https://infos.ademe.fr/magazine-janvier-2025/numerique-quel-impact-environnemental-en-2022/
- Agence de l’environnement et de la maitrise de l’énergie [ADEME]. (2022). Evaluation de l'impact environnemental de la digitalisation des services culturels. La Librairie ADEME. Consultado el 10 de septiembre de 2025.
- Agence Internationale de l'Energie [IEA]. (2023, 11 juillet). Data Centres and Data Transmission Networks. (Rozite, V., Bertoli, E., & Reidenbach, B.)
- Dodge, J., Prewitt, T., Combes, R. T. D., Odmark, E., Schwartz, R., Strubell, E., Luccioni, A., Smith, N. A., DeCario, N., & Buchanan, W. (2022). Measuring the carbon intensity of AI in cloud instances. 2022 ACM Conference on Fairness, Accountability, and Transparency.
- Google. (2009, 11 janvier). Powering a Google search. Consultado el 14 de septiembre de 2025.
- Jurafsky, D., Chai, J., Schluter, N., & Tetreault, J. (2020. juillet). The 58th Annual Meeting of the Association for Computational Linguistics. Proceedings of the Conference [PDF]. ACL 2020.
- Lee, J. Y. (2023, 27 février). Can an artificial intelligence chatbot be the author of a scholarly article? Journal of Educational Evaluation for Health Professions, 20, Article 6. https://doi.org/10.3352/jeehp.2023.20.6
- Luccioni, A. S., Viguier, S., & Ligozat, A.-L. (2022). Estimating the Carbon Footprint of BLOOM, a 176B Parameter Language Model [PDF]. arXiv (Cornell University).
- Ludvigsen K. (2023, 06 août). ChatGPT’s energy use per query. How much electricity does ChatGPT use to answer one question?. Medium.
- Strubell, E., Ganesh, A., & McCallum, A. (2019). Energy and Policy Considerations for Deep Learning in NLP. In Proceedings of the 57th Annual Meeting of the Association for Computational Linguistics (pp. 3645–3650). Association for Computational Linguistics. https://doi.org/10.18653/v1/P19-1355
- Schwartz, R., Dodge, J., Smith, N. A., & Etzioni, O. (2020). Green AI. Communications of the ACM, 63(12), 54–63.
- Standford University. (2023). AI Index Report.
- Zodhya. (2023). How much energy does ChatGPT consume? Medium. Consultado el 10 de septiembre de 2025.
Para profundizar
- Bordage, F. (2011. 10 février). ¿Cuál es la huella de carbono de una computadora? GreenIT. Consultado el 22 de agosto de 2024.
- Bouramdane, A.A. (2023, 01 février). Minéraux de la Transition Énergétique : Criticité Géologique, Géostratégique et Environnementale. Energie / mines et carrières Magazine, 1-7. Consultado el 22 de agosto de 2024.
- CNRS. (2015). Los efectos rebote de la tecnología digital. EcoInfo.
- Dedryver, L. (2020). El consumo de metales en el sector digital: un sector lejos de estar desmaterializado. France Stratégie. Consultado el 22 de agosto de 2024.
- Moriarty, P., & Wang, S. J. (2017). Can Electric Vehicles Deliver Energy and Carbon Reductions? Energy Procedia, 105, 2983–2988. Consultado el 22 de agosto de 2024.
- Stephant, A. (2023, 26 septembre). [Conferencia]. Université de Lausanne. Consultado el 22 de agosto de 2024.